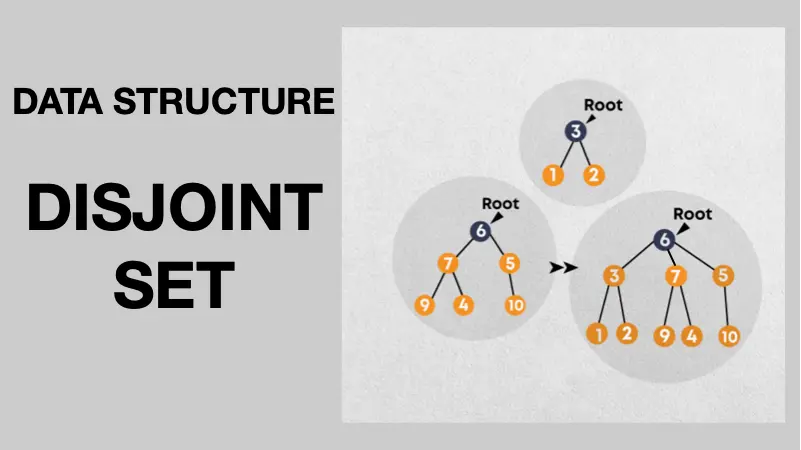
并查集
并查集是一种用于处理元素分组的集合数据结构,支持两个核心操作:合并两个集合、查询两个元素是否属于同一集合,借助路径压缩与按秩合并优化,能近乎常数时间完成操作,常用于连通性判断、图论连通分量等场景。
数据结构
页码7/11
并查集是一种用于处理元素分组的集合数据结构,支持两个核心操作:合并两个集合、查询两个元素是否属于同一集合,借助路径压缩与按秩合并优化,能近乎常数时间完成操作,常用于连通性判断、图论连通分量等场景。
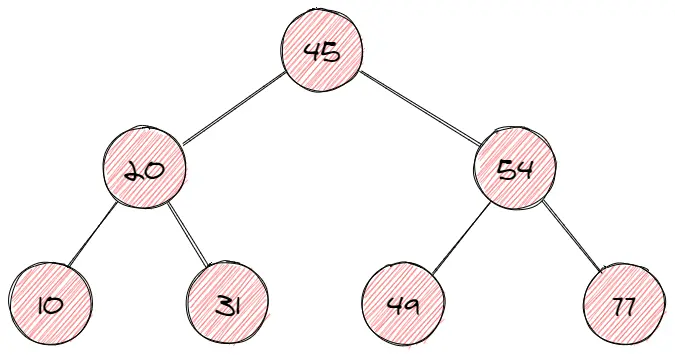
二叉搜索树是一种二叉树,对任意结点,其左子树所有结点值小于该结点值,右子树所有结点值大于该结点值,利用该性质可高效完成查找、插入与删除操作。
堆是一种完全二叉树形式的特殊数据结构,分为大顶堆、小顶堆;父节点值分别大于 / 小于等于子节点,适合快速获取最值,底层常用数组存储,核心操作是上浮、下沉,常用来实现优先队列、堆排序。
哈夫曼树是带权路径长度最小的二叉树,通过不断选取权值最小的两个节点合并生成父节点构建而成,没有度为 1 的结点,常用来构造最优前缀编码,实现数据的高效压缩。
二叉树遍历是按特定规则访问树中每一个节点且仅访问一次的操作,常见有前序、中序、后序、层序四种方式,前三种以根节点访问顺序区分,层序按从上到下逐层访问,遍历是二叉树查找、修改、输出等运算的基础。
树是一种非线性的数据结构,由节点和边组成,存在唯一根节点,每个节点可以拥有多个子节点,无环路;适合表达层级、从属关系,常用于文件目录、二叉搜索、排序索引等场景。
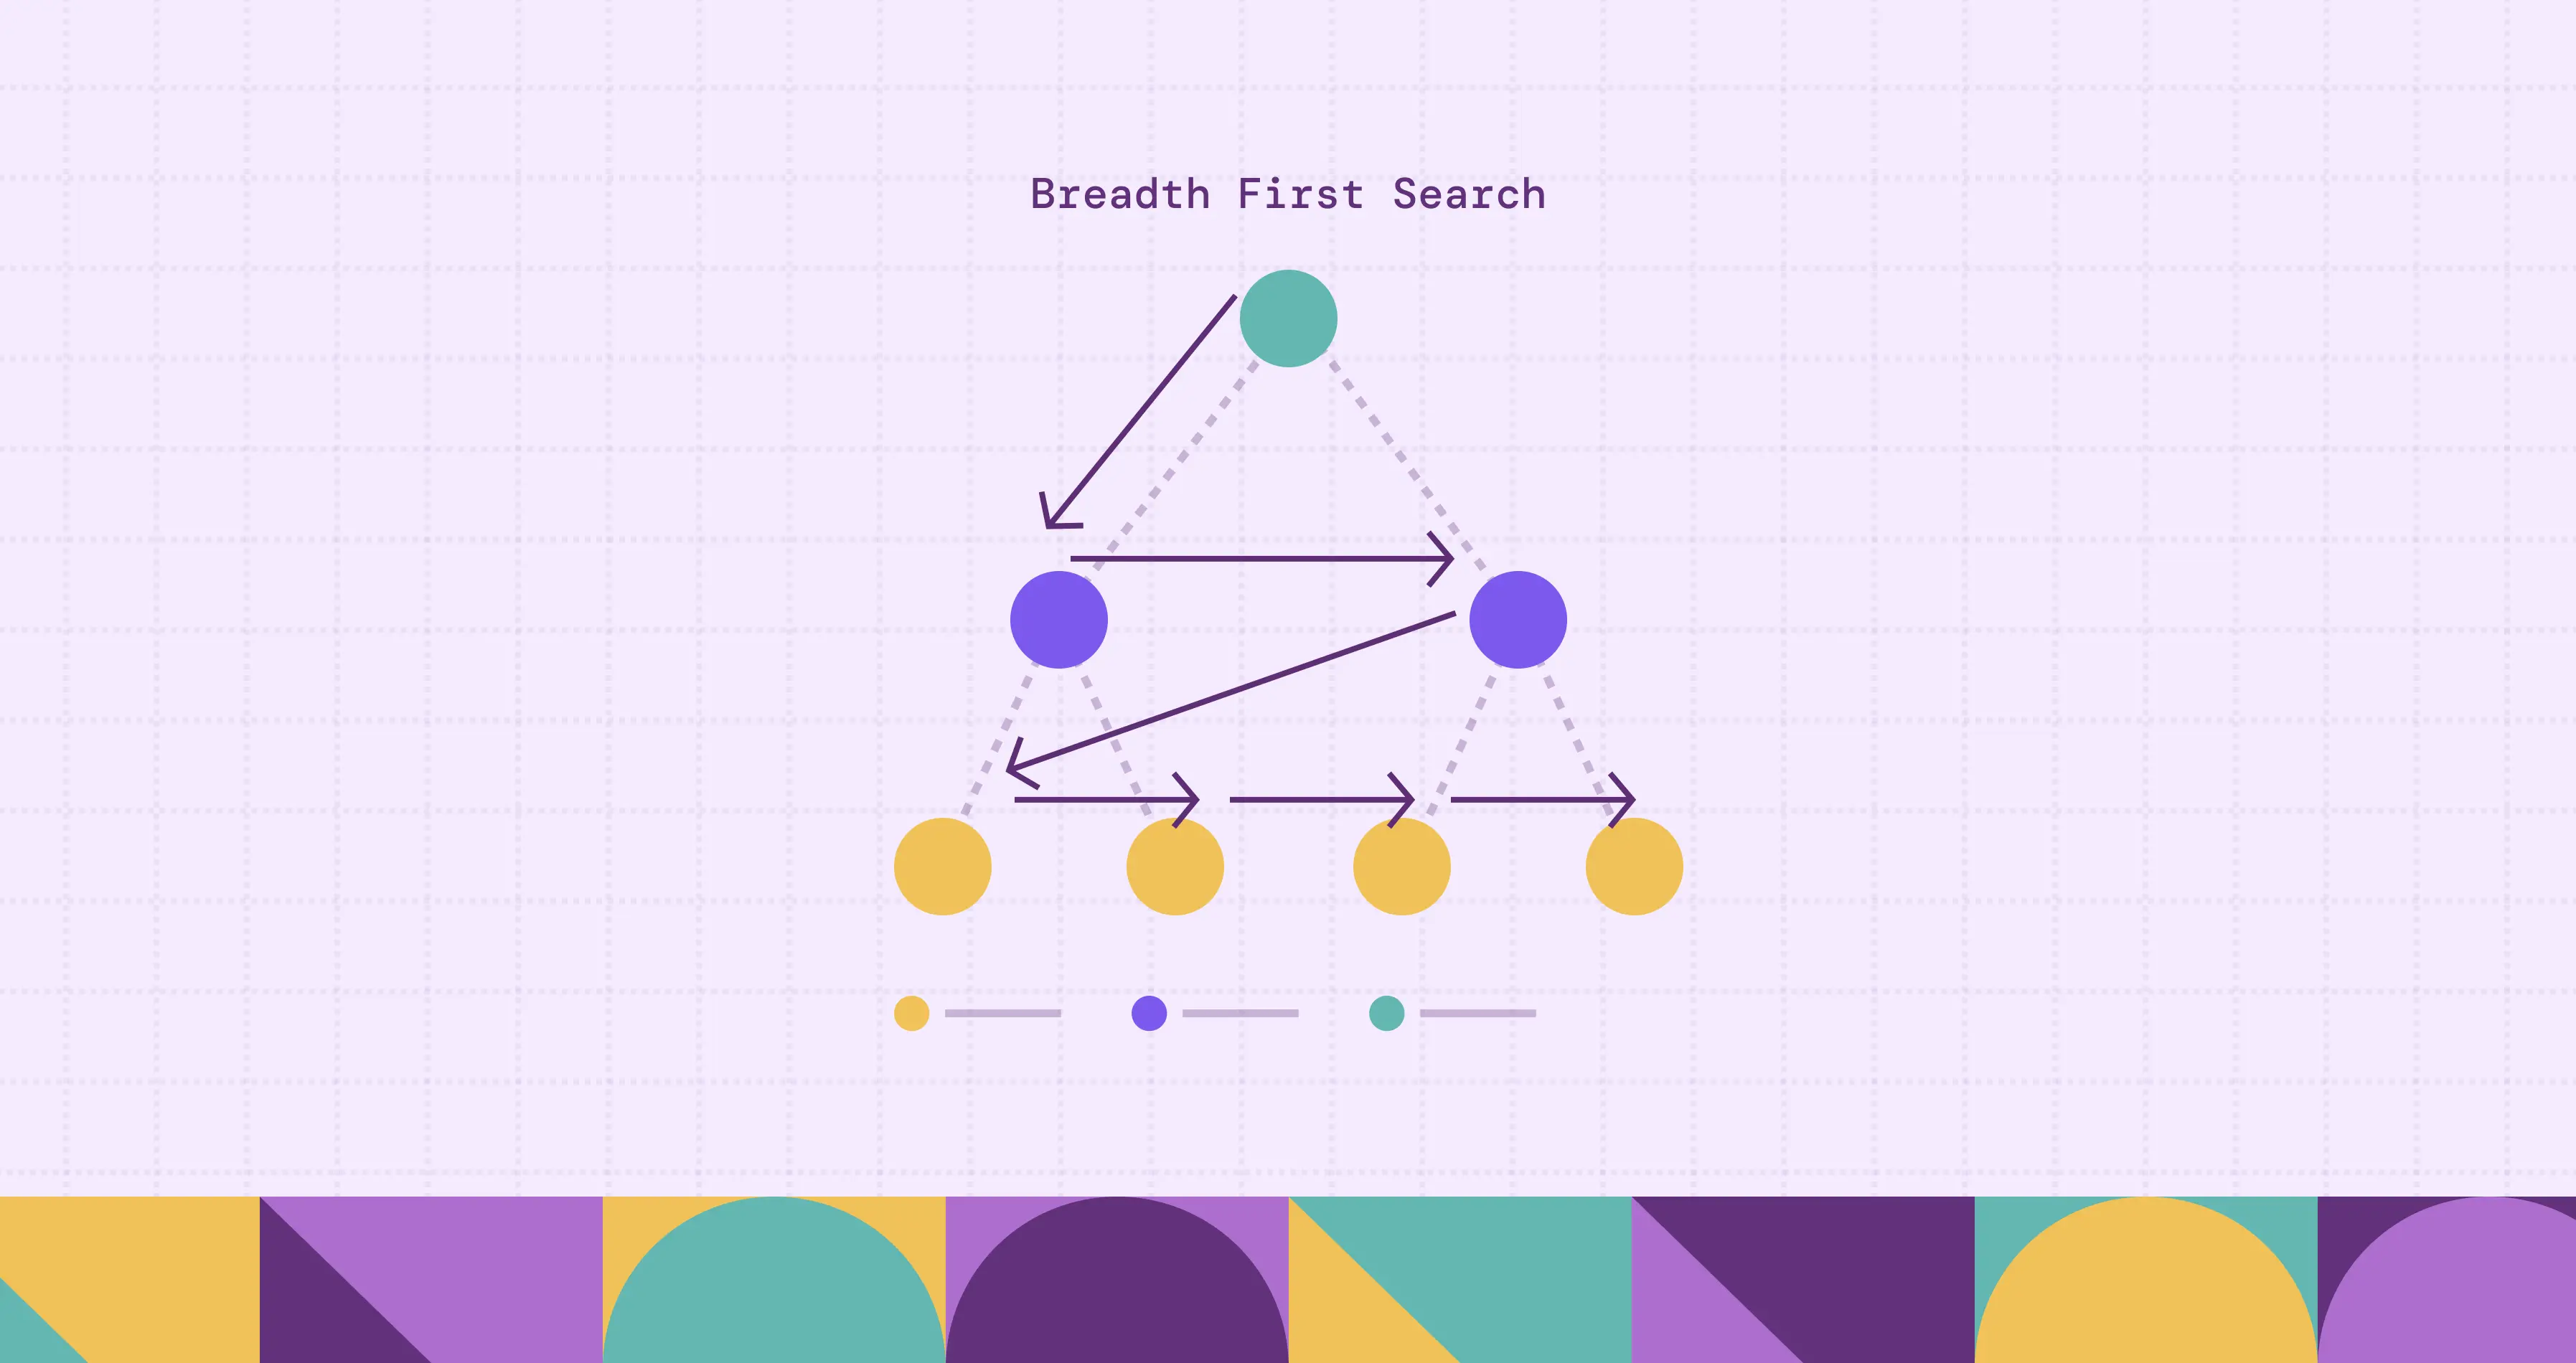
图的广度优先搜索(BFS)从起始顶点出发,优先访问当前节点的所有相邻顶点,再逐层向外扩展遍历,依靠队列实现,适合求最短路径、寻找连通分量,按层遍历各个结点。
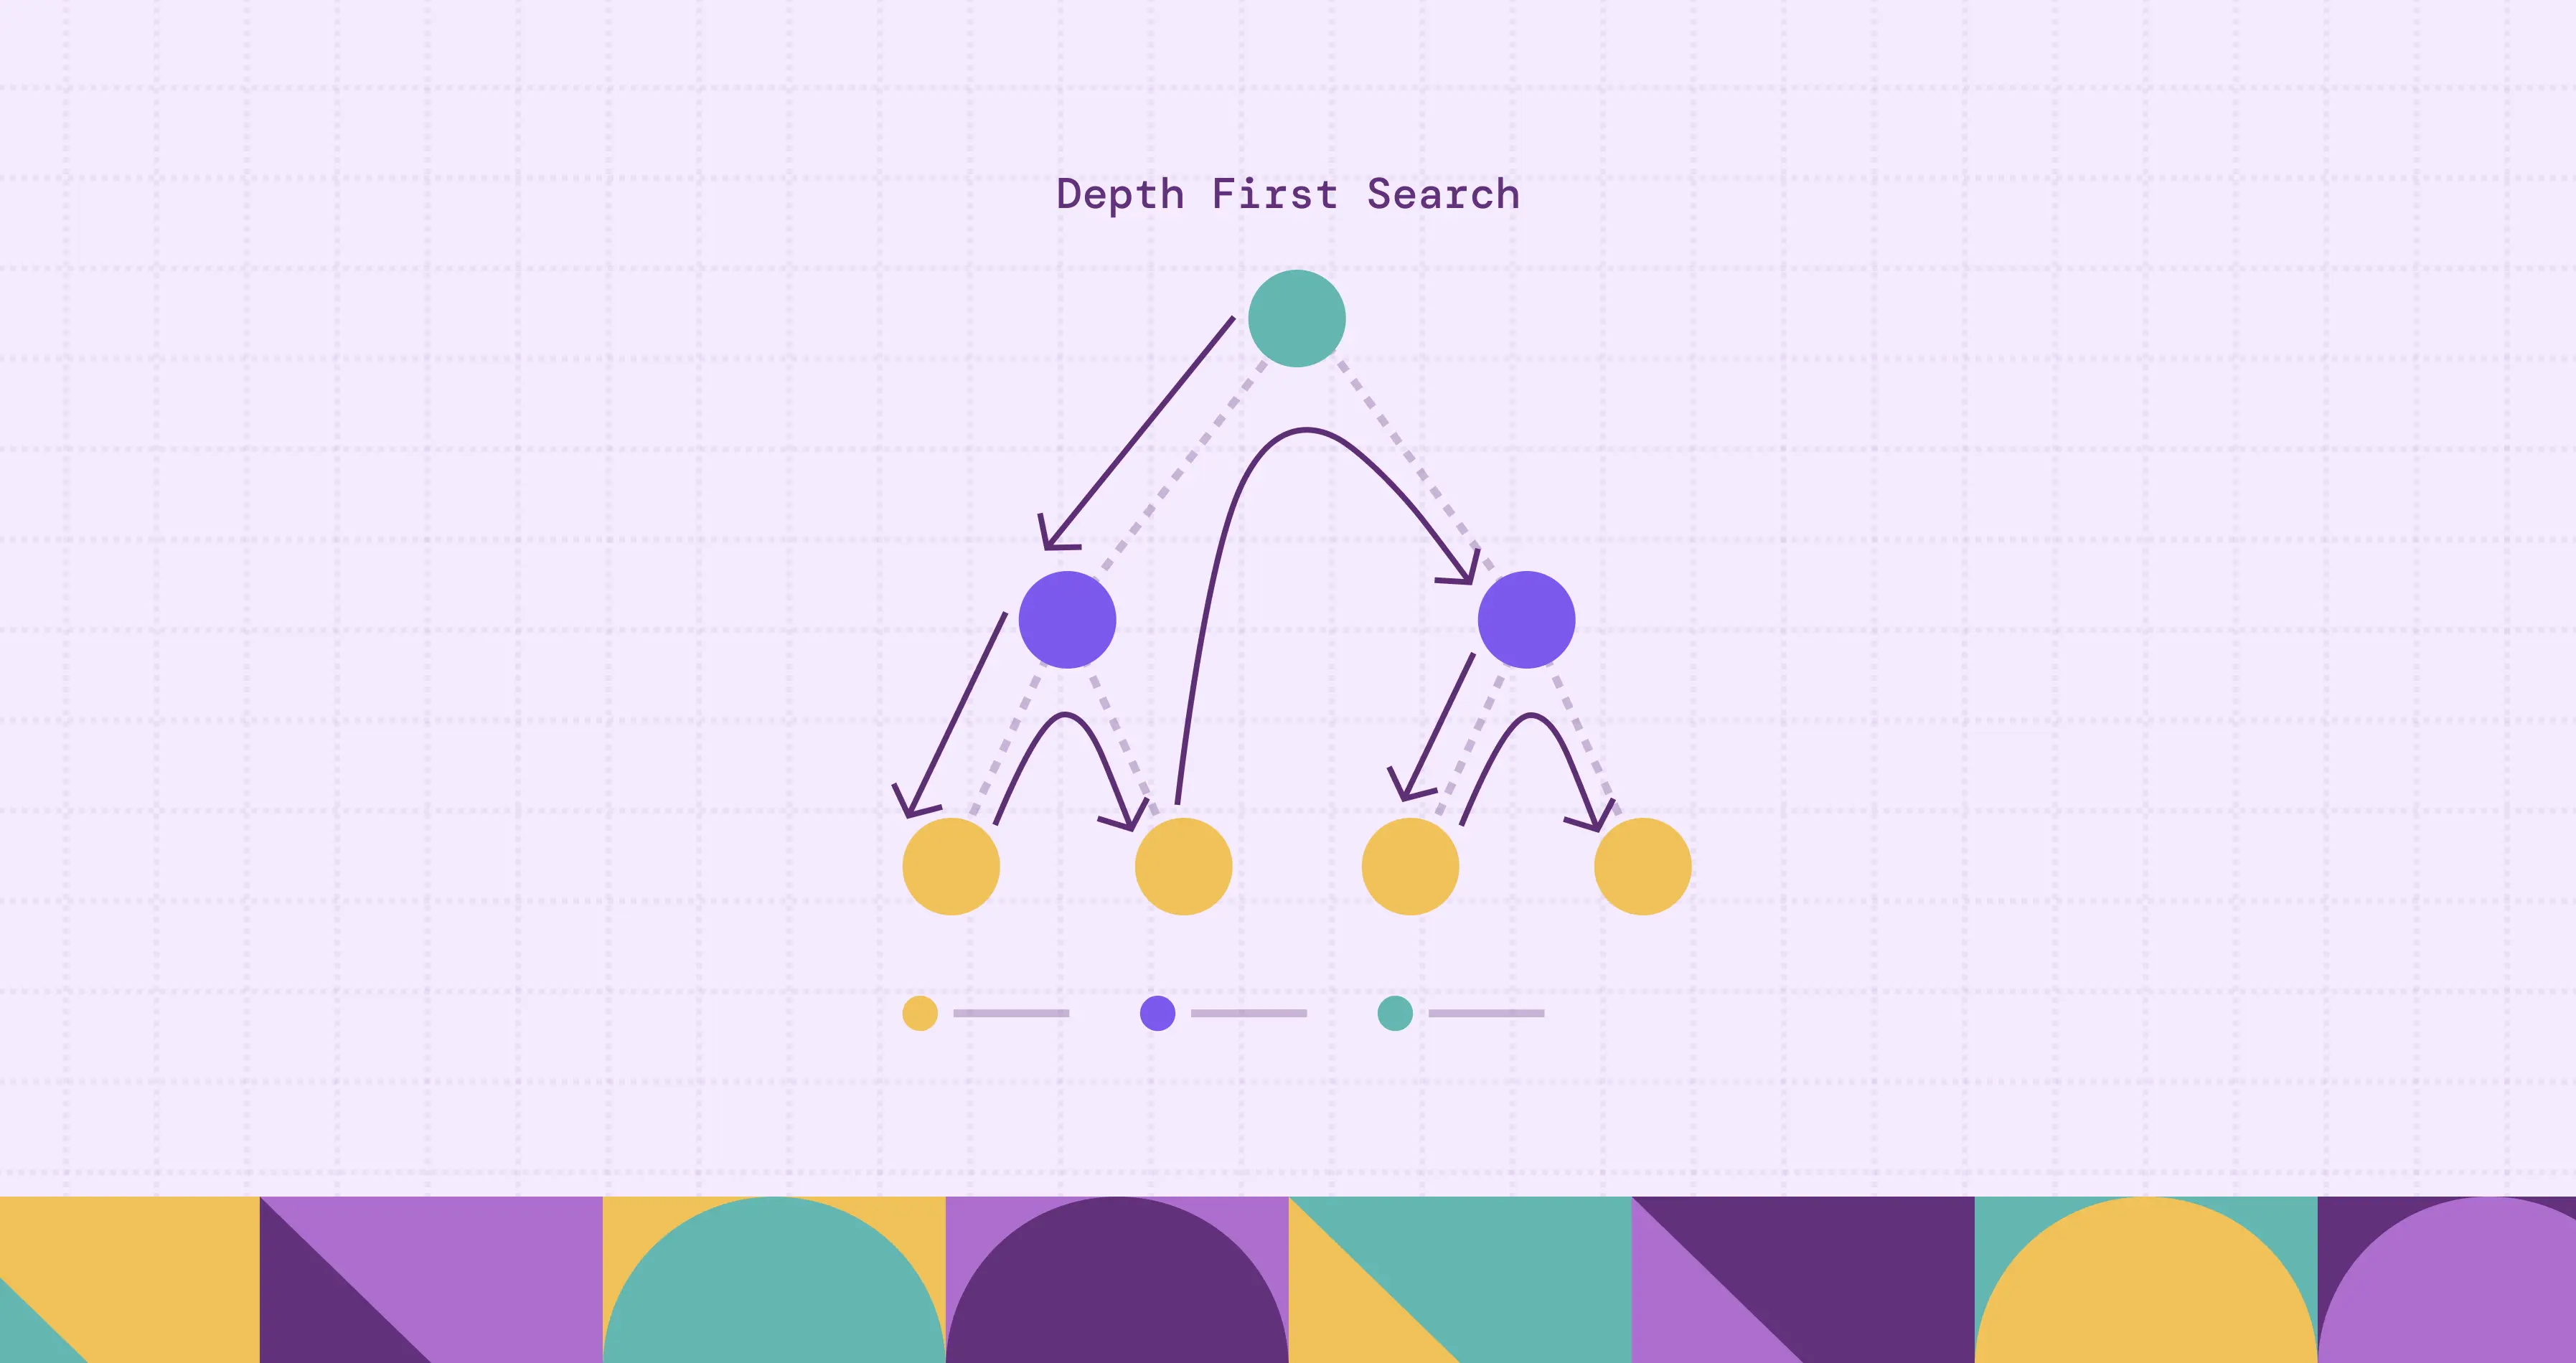
图的深度优先搜索(DFS)从起始顶点出发,沿着一条路径尽可能向下访问,走到尽头再回溯,遍历未访问过的邻接顶点,借助栈或递归实现,可遍历图中连通分量,能用于找路径、判断连通性。