哈夫曼树
哈夫曼树是带权路径长度最小的二叉树,通过不断选取权值最小的两个节点合并生成父节点构建而成,没有度为 1 的结点,常用来构造最优前缀编码,实现数据的高效压缩。
数据结构1分钟阅读
哈夫曼树(Huffman Tree),又称最优二叉树,是数据结构与算法中一种非常经典的二叉树结构。
它的核心思想是:带权路径长度(WPL)达到最小。简单来说,在频次高(权重大)的节点离根节点更近,频次低(权重小)的节点离根节点更远,从而实现整体的高效寻址或压缩。
为了理解哈夫曼树,需要先明确以下几个基础概念:
-
路径与路径长度:从树中的一个节点到另一个节点之间的分支构成路径;路径上的分支数目称为路径长度。
-
节点的带权路径长度:从根节点到该节点之间的路径长度 该节点的权值(Weight)。
-
树的带权路径长度(WPL, Weighted Path Length):树中所有叶子节点的带权路径长度之和。计算公式为:
- :第 个叶子节点的权值。
- :根节点到第 个叶子节点的路径长度(深度)。
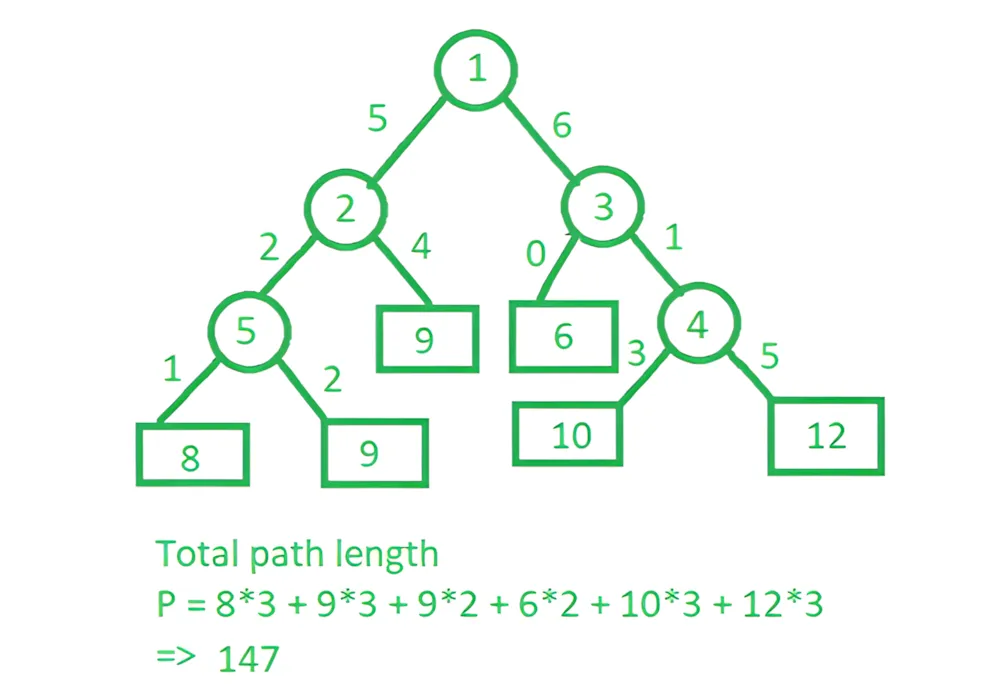
哈夫曼树的定义:在含有 n 个带权叶子节点的所有二叉树中,WPL 最小的那棵二叉树就是哈夫曼树。
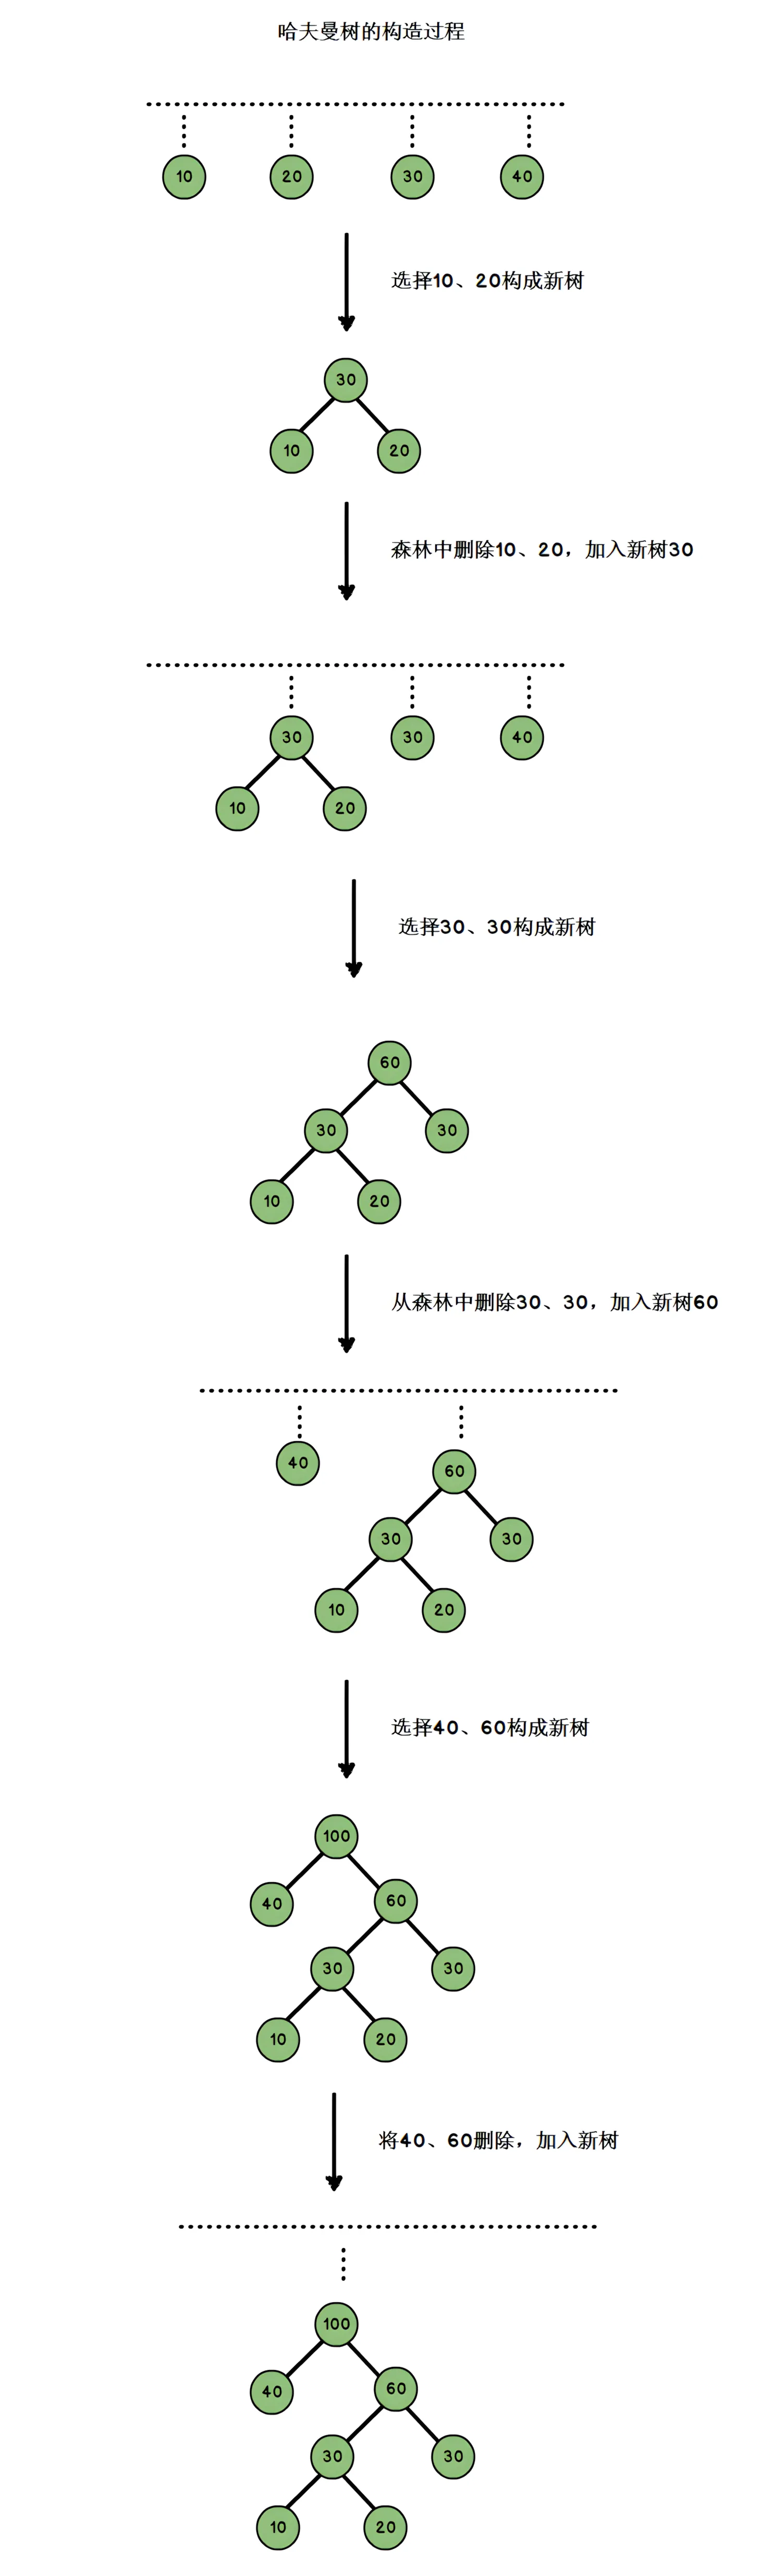
假设有 个权值,构造哈夫曼树的算法步骤如下(贪心策略):
- 初始化:将这 个权值分别作为 棵只有根节点的二叉树,形成一个森林 。
- 选取:在森林 中挑选权值最小的两棵树作为左右子树。
- 合并:构造一棵新的二叉树,新树根节点的权值为其左右子树根节点权值之和。
- 替换:从森林 中删除刚才选取的两棵树,并将新构造的树加入 中。
- 重复:重复步骤 2~4,直到森林 中只剩下一棵树为止。这棵树就是哈夫曼树。
- 只有度为 0 和度为 2 的节点:哈夫曼树中没有单分支节点(度为 1 的节点)。如果叶子节点数为 ,则树中的总节点数为 。
- 权值越大的节点越靠近根节点,权值越小的节点越远离根节点。
- 哈夫曼树形态不唯一:当存在多个相同最小权值的节点时,选择顺序不同可能导致树的形态不同,但最终计算出的 WPL 是唯一且最小的。
基于最小堆(优先队列)实现哈夫曼树的构建:
#include <iostream>#include <queue>#include <vector>
using namespace std;
// 哈夫曼树节点结构struct Node {    char data;    int weight;    Node *left, *right;
    Node(char d, int w) : data(d), weight(w), left(nullptr), right(nullptr) {}};
// 比较规则:定义最小堆struct Compare {    bool operator()(Node* a, Node* b) {        return a->weight > b->weight;    }};
// 构建哈夫曼树Node* buildHuffmanTree(const vector<pair<char, int>>& items) {    priority_queue<Node*, vector<Node*>, Compare> minHeap;
    for (auto item : items) {        minHeap.push(new Node(item.first, item.second));    }
    while (minHeap.size() > 1) {        Node* left = minHeap.top(); minHeap.pop();        Node* right = minHeap.top(); minHeap.pop();
        // 创建新内部节点,无实际字符数据,权值为左右节点之和        Node* parent = new Node('\0', left->weight + right->weight);        parent->left = left;        parent->right = right;
        minHeap.push(parent);    }
    return minHeap.top(); // 返回根节点}
// 递归打印哈夫曼编码void printCodes(Node* root, string code) {    if (!root) return;
    // 叶子节点,输出编码    if (!root->left && !root->right) {        cout << root->data << ": " << code << endl;    }
    printCodes(root->left, code + "0");    printCodes(root->right, code + "1");}
int main() {    vector<pair<char, int>> items = {{'A', 5}, {'B', 2}, {'C', 7}, {'D', 4}};
    Node* root = buildHuffmanTree(items);
    cout << "哈夫曼编码结果:" << endl;    printCodes(root, "");
return 0;}- 时间复杂度:利用优先队列(小顶堆)构建哈夫曼树的时间复杂度为 ,其中 为字符/节点种类数。
- 空间复杂度:需要创建 个节点,空间复杂度为 。
- 主要优势:理论上能达到最佳前缀码压缩效率,广泛用于文件压缩(如 ZIP、GZIP)以及图像/音频传输(如 JPEG、MP3 中的部分步骤)。