堆排序
堆排序利用大顶堆(或小顶堆)的堆性质,先将待排序数组构建成堆,反复取出堆顶最大元素放到末尾,再调整剩余元素维持堆结构,完成排序;时间复杂度稳定\(O(n\log n)\),原地排序,属于不稳定排序。
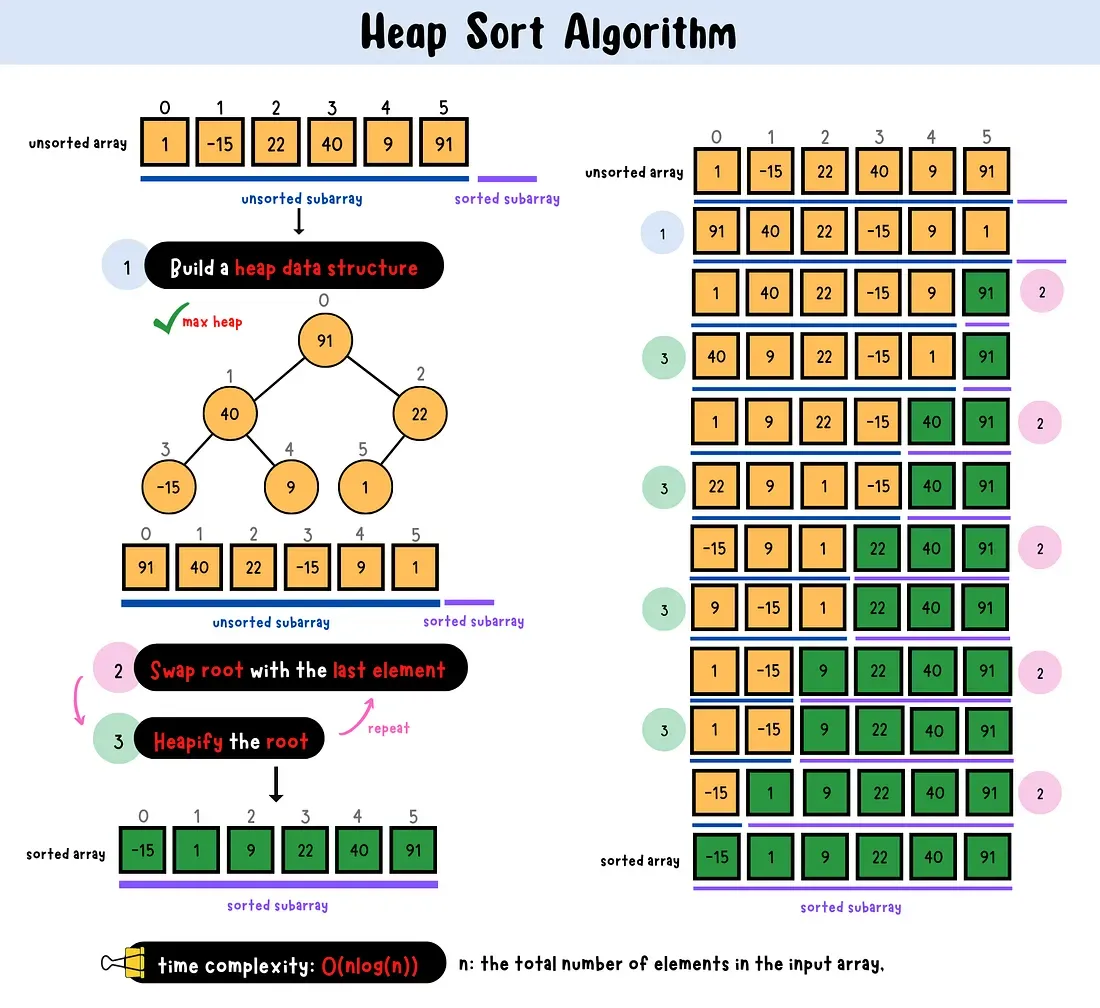
堆排序(Heap Sort) 是一种基于比较的排序算法,利用 二叉堆(Binary Heap) 这种数据结构来实现。它的核心思想是将无序数组构造成一个堆,通过不断取出堆顶元素(最大值或最小值),从而达到排序的目的。
堆排序的时间复杂度固定为 ,且是一种原地排序算法(不需要额外的辅助空间)。
堆是一种特殊的完全二叉树,在逻辑上是树形结构,在物理上通常用连续的数组来存储。
- 最大堆(大顶堆): 每个节点的值都大于或等于其左右子节点的值。即
arr[i] >= arr[2i+1]且arr[i] >= arr[2i+2]。用于升序排序。 - 最小堆(小顶堆): 每个节点的值都小于或等于其左右子节点的值。即
arr[i] <= arr[2i+1]且arr[i] <= arr[2i+2]。用于降序排序。
以升序排序(构建大顶堆)为例,堆排序分为两个核心阶段:
把无序的原始数组构建成一个大顶堆。
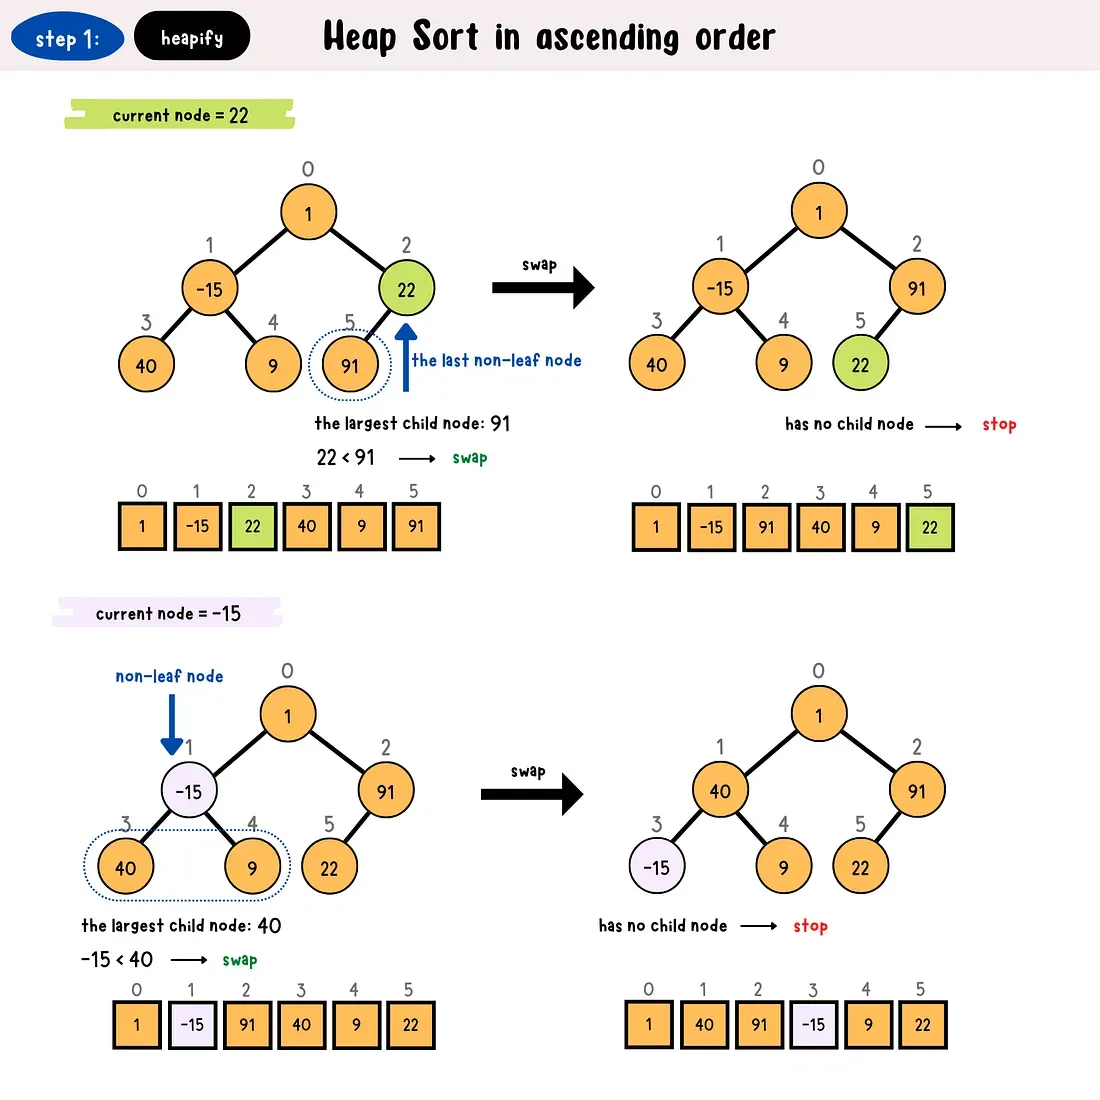
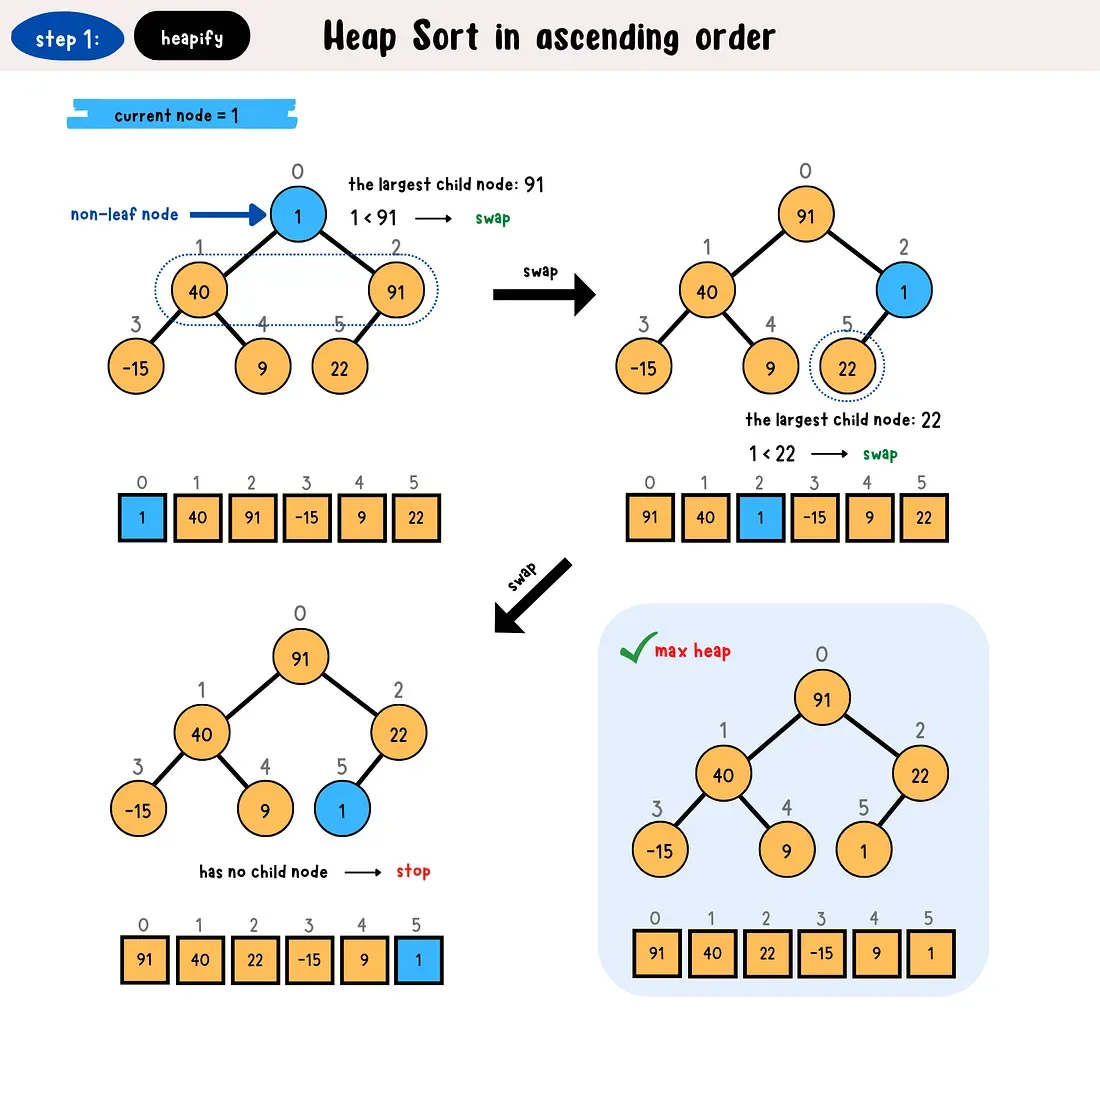
- 从最后一个非叶子节点开始(索引为
n/2 - 1)。 - 从右到左、从下到上依次对每个节点执行下沉调整(Heapify),确保每个子树都满足大顶堆性质。
- 将堆顶元素(此时数组的最大值,即
arr[0])与当前堆的最后一个元素交换。 - 缩小堆的范围(有效堆大小减 1),此时最大值已沉底固定。
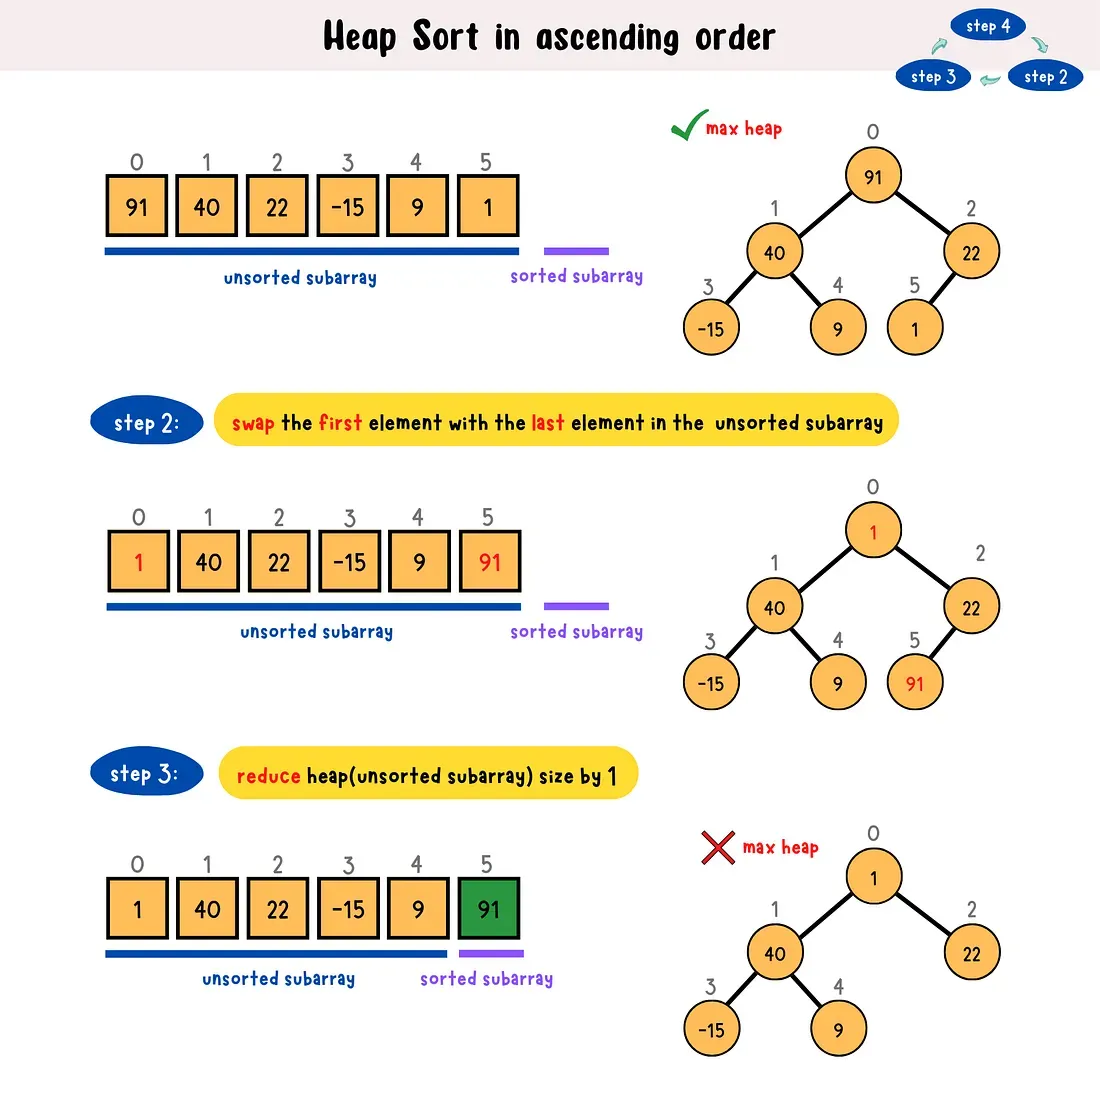
将堆顶最大元素交换到无序段末尾,归入已排序区间;缩小堆逻辑长度,剩余部分堆性质被破坏,需要重新堆化。 - 对新的堆顶
arr[0]执行下沉调整(Heapify),重新恢复大顶堆性质。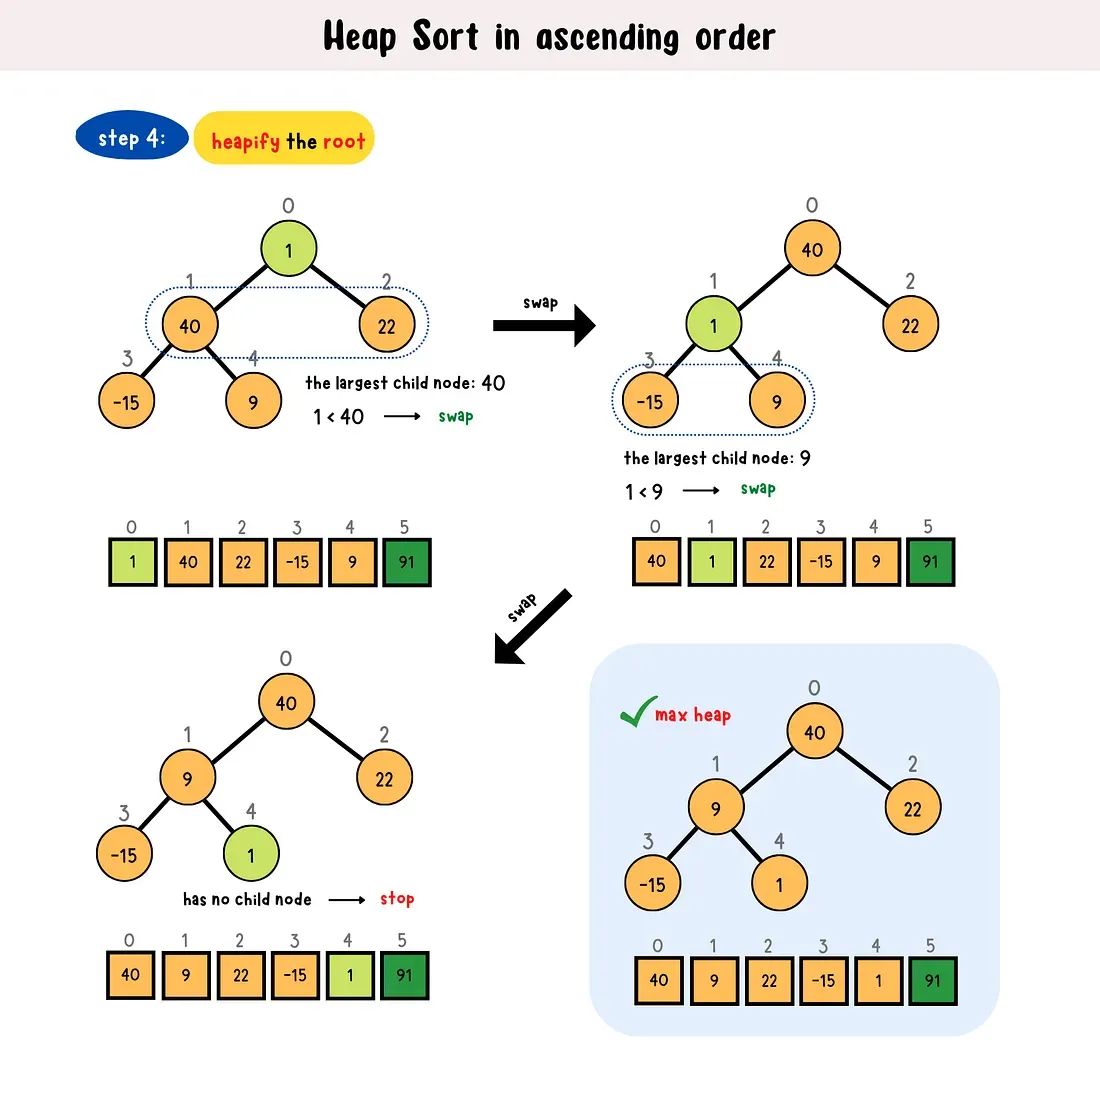
堆规模缩小后只需要对根节点执行 heapify,即可重新恢复大顶堆;不断循环该流程,有序区间持续向前扩张。 - 重复上述步骤,直到堆的大小缩小为 1,整个数组排序完成。
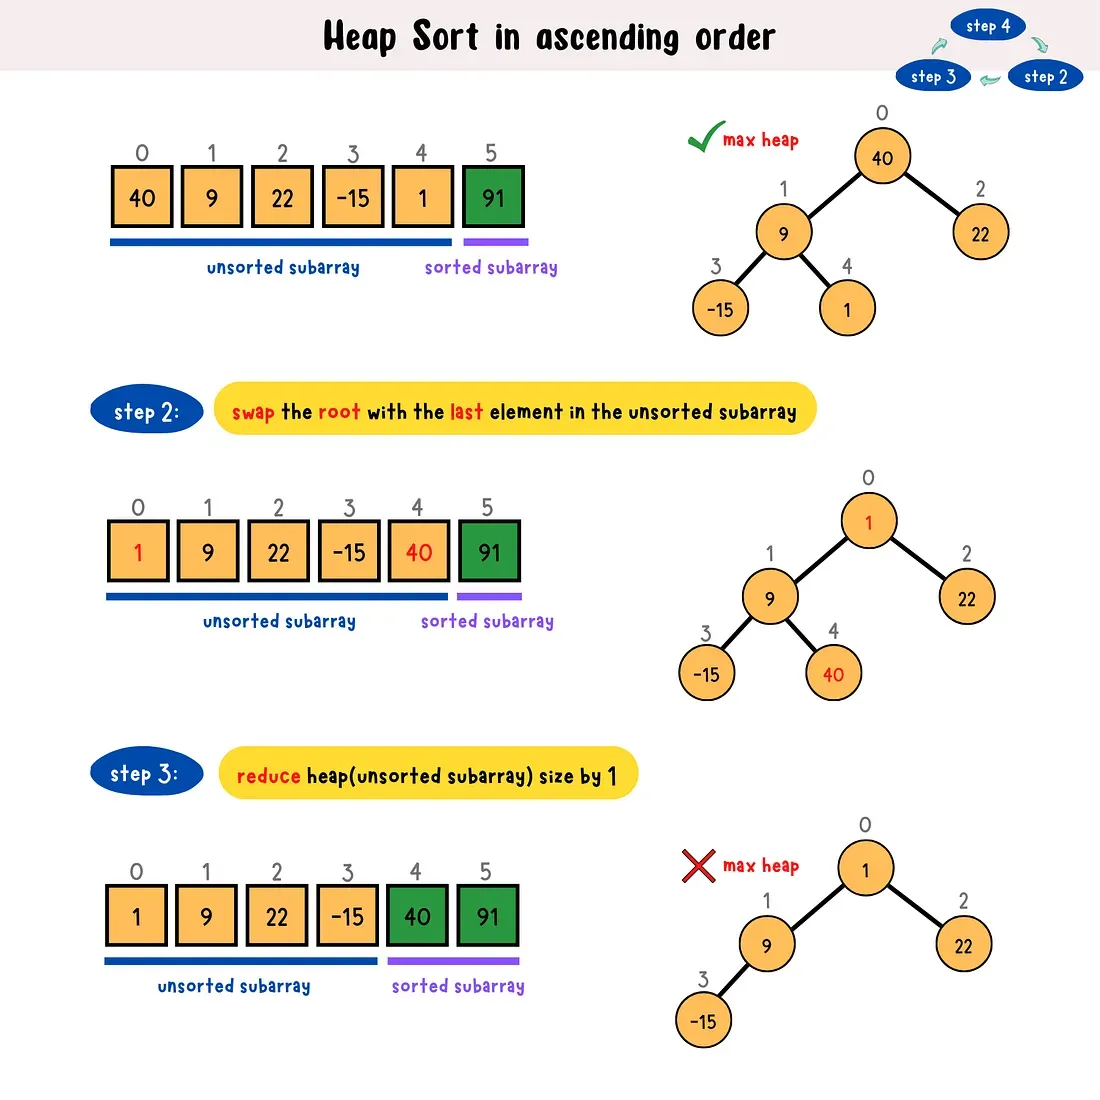
无序区为大顶堆数组 [40,9,22,-15,1]。步骤 2 交换堆顶 40 与无序区末尾元素 1,将最大值 40 移入尾部有序子数组。步骤 3 堆有效长度减 1,不再把 40 视作堆成员;剩余无序部分不再满足大顶堆。 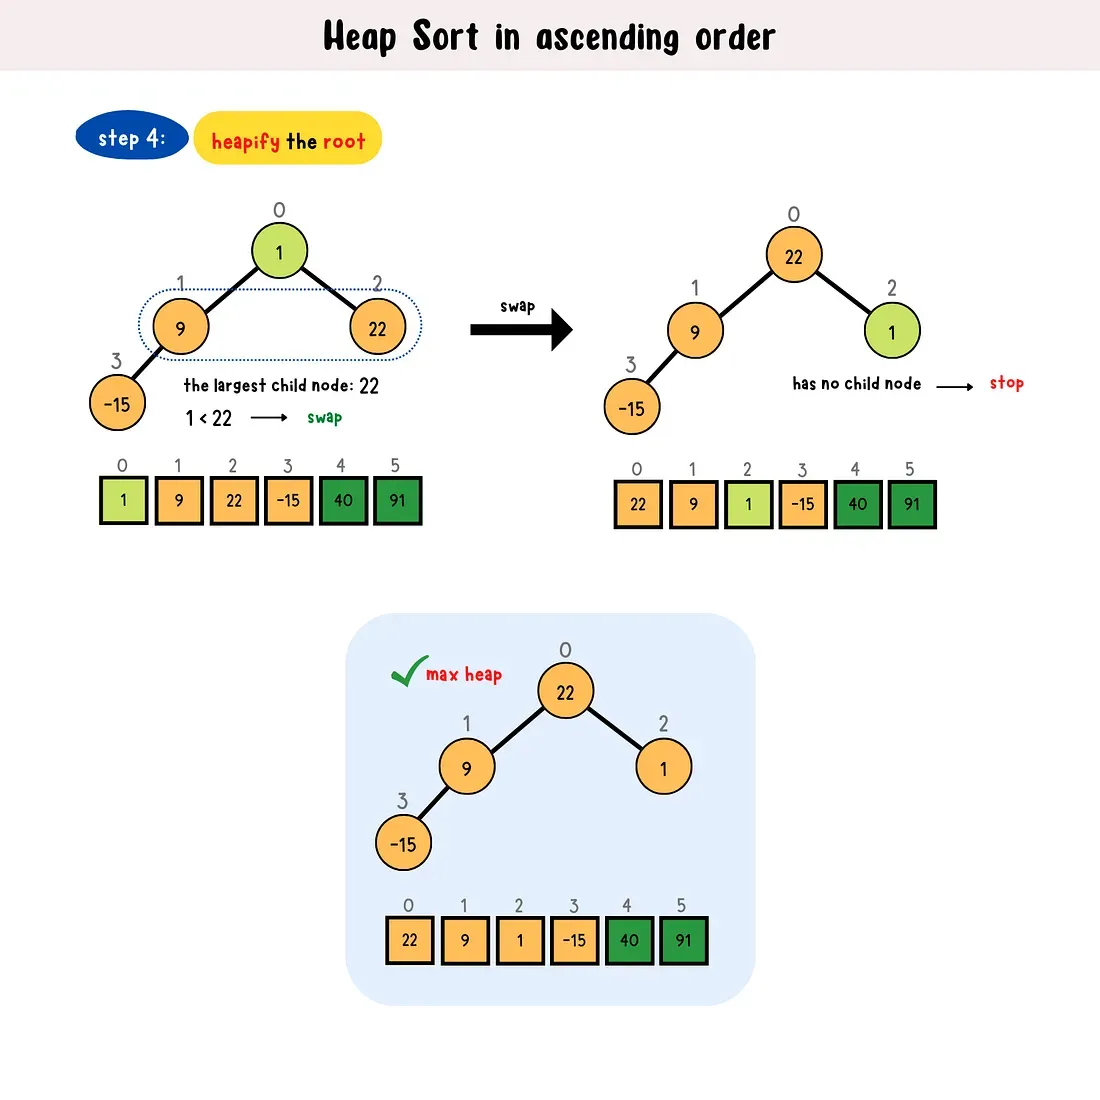
对根节点 1 执行 heapify 堆化,与最大子节点 22 交换,节点下沉至叶子停止;无序区间重建大顶堆,数组:[22,9,1,-15,40,91]。 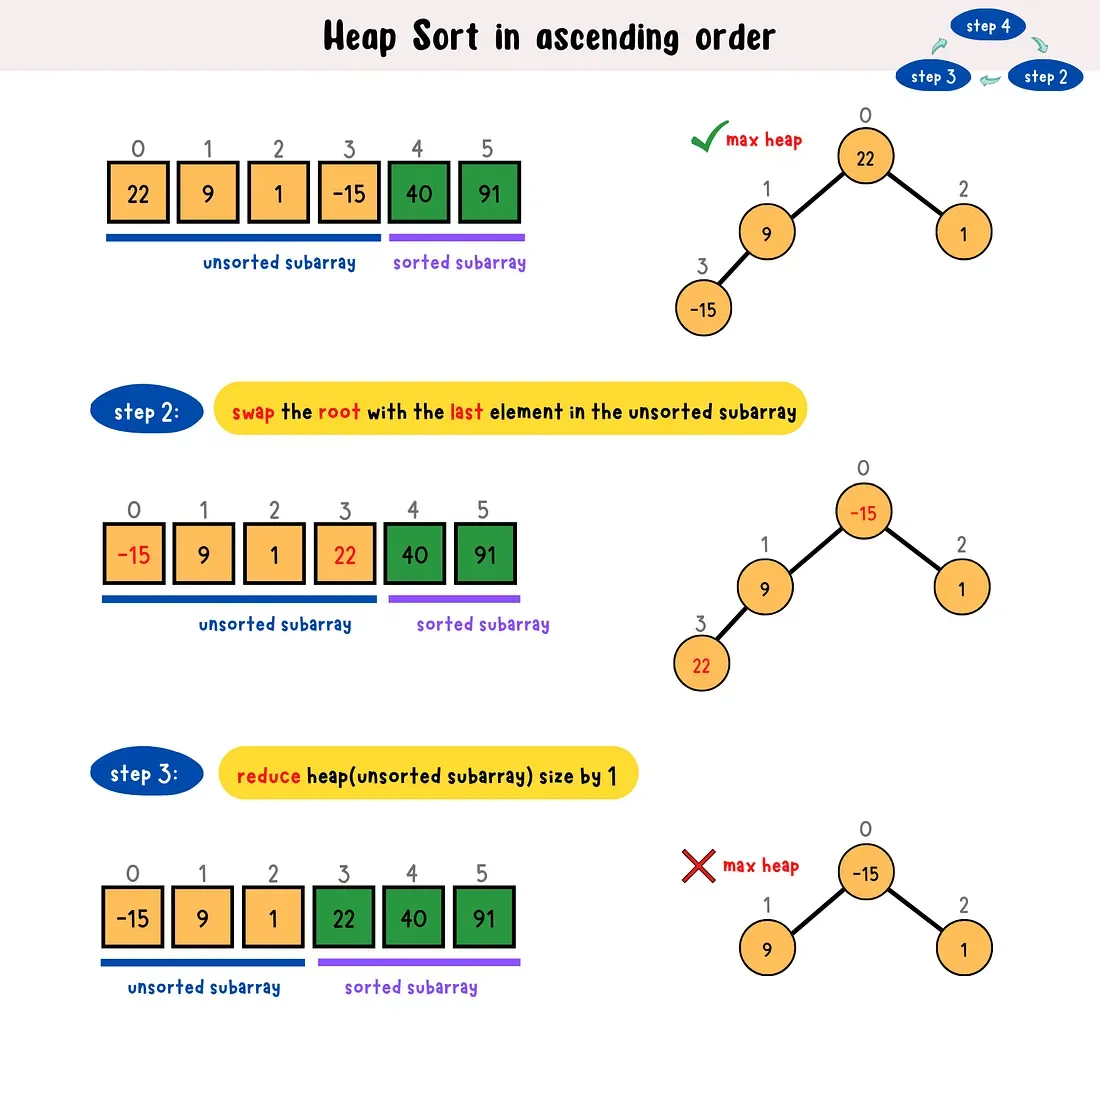
无序大顶堆数组 [22,9,1,-15]。步骤 2 交换堆顶 22 与无序末尾‑15,22 归入有序区。步骤 3 堆大小减一,剩余数组不再满足大顶堆。 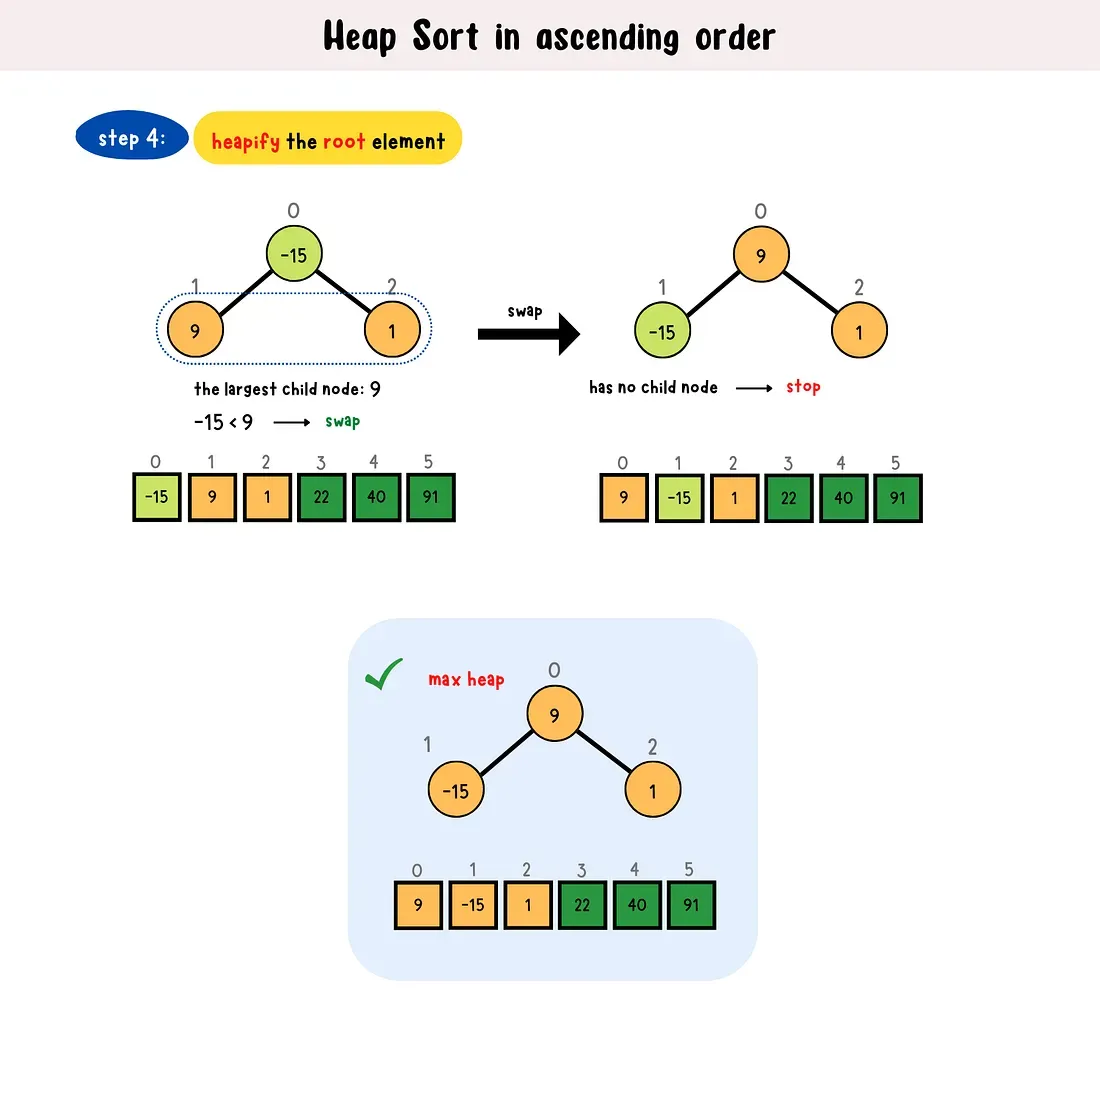
根节点‑15 执行 heapify,与最大子节点 9 交换下沉,完成堆修复;无序区数组:[9,-15,1]。 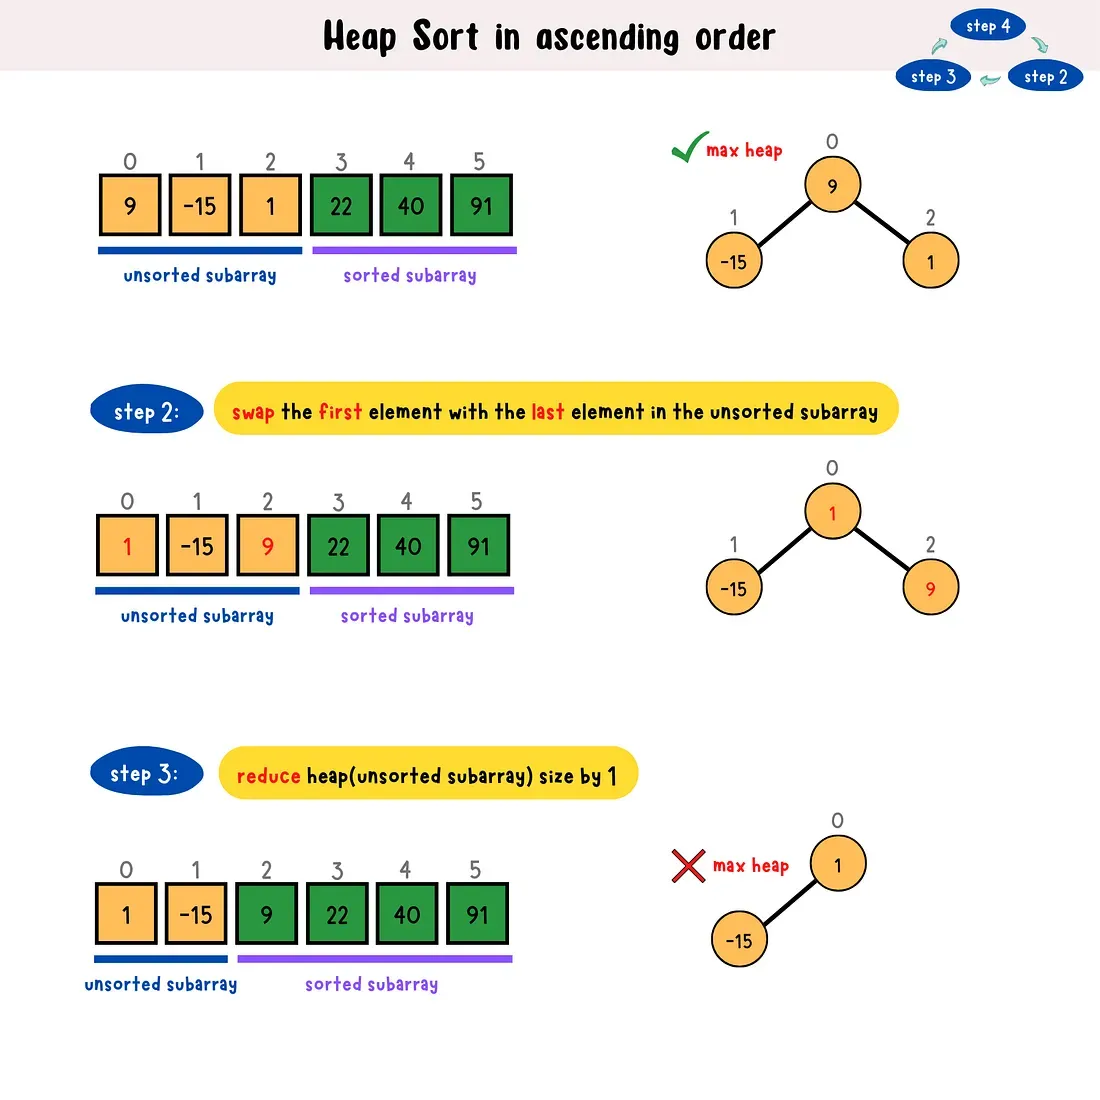
无序大顶堆 [9,-15,1]。步骤 2 交换堆顶 9 和无序末尾 1,9 归入有序区。步骤 3 堆尺寸减一,剩余部分堆性质失效。 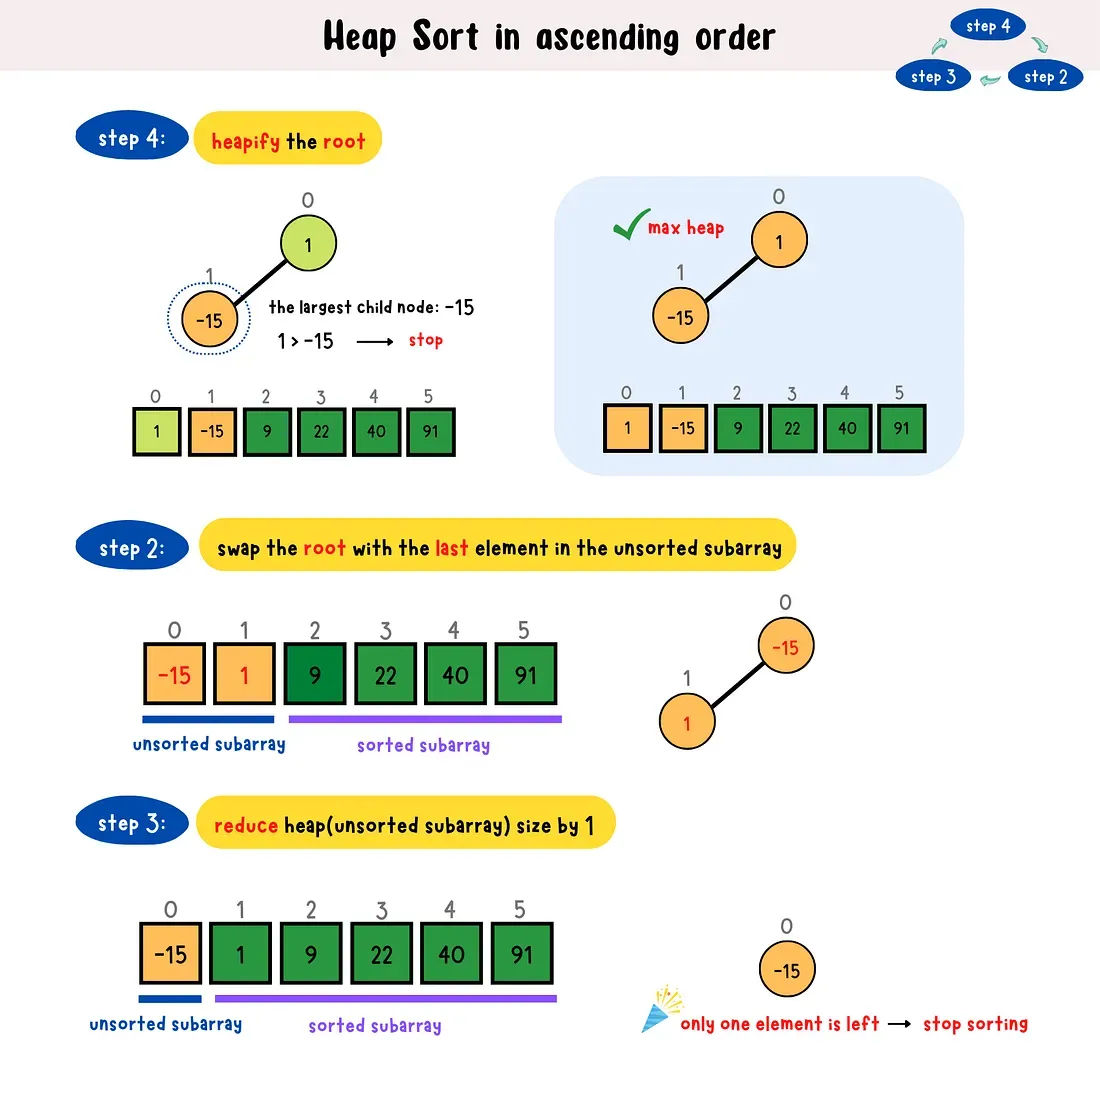
根节点 1 执行 heapify,子节点‑15 更小,无需交换;执行最后一轮交换,把 1 归入有序区;堆仅剩下元素‑15,算法终止。 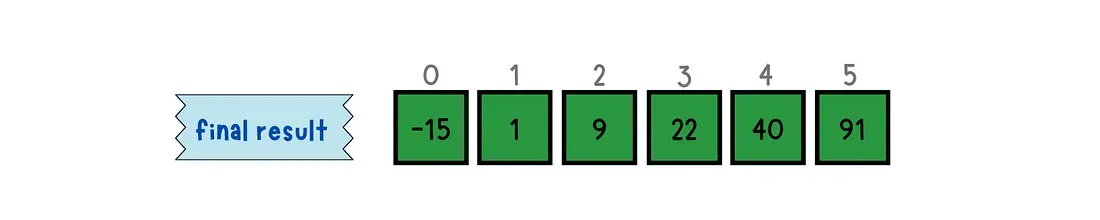
经过多轮 “交换堆顶‑缩小堆‑根堆化” 循环,得到完整升序数组:[-15, 1, 9, 22, 40, 91],所有元素全部进入有序区间,排序完成。
#include <iostream>#include <vector>using namespace std;
void heapify(vector<int>& arr, int n, int i) {    int largest = i;    int left = 2 * i + 1;    int right = 2 * i + 2;
    if (left < n && arr[left] > arr[largest])        largest = left;
    if (right < n && arr[right] > arr[largest])        largest = right;
    if (largest != i) {        swap(arr[i], arr[largest]);        heapify(arr, n, largest);    }}
void heapSort(vector<int>& arr) {    int n = arr.size();
    // 建堆    for (int i = n / 2 - 1; i >= 0; i--)        heapify(arr, n, i);
// 排序 for (int i = n - 1; i > 0; i--) { swap(arr[0], arr[i]); heapify(arr, i, 0); }}| 维度 | 分析 / 结论 | 说明 |
|---|---|---|
| 最好时间复杂度 | 即使原数组有序,建堆与调整的总体开销仍为 | |
| 最坏时间复杂度 | 任何情况下都需要经历完整的建堆和 次调整 | |
| 平均时间复杂度 | 性能非常稳定 | |
| 空间复杂度 | 原地排序,仅需常数级别的变量空间(迭代实现时) | |
| 稳定性 | 不稳定排序 | 在堆顶与堆尾交换时,可能会破坏相同元素的相对顺序 |
- 稳定高效: 无论数据初始状态如何,时间复杂度始终锁定在 ,不会像快速排序那样退化到 。
- 空间占用极低: 属于原地排序,不需要额外的数组空间。
- CPU 缓存不友好: 堆排序依赖父子节点跳跃式的访问(例如从索引
i跳转到2i+1),这会导致较高的 CPU Cache Miss(缓存未命中)率。因此在实际工程中,整体速度通常慢于快速排序。 - 不稳定: 不适用于要求保持等值元素相对顺序的场景。
- Top-K 问题: 在大量数据(如 10 亿个数据)中找出前 K 个最大/最小的元素。此时不需要对全部数据排序,仅维护一个大小为 K 的堆即可,空间复杂度降至 。
- 优先队列(Priority Queue): C++ 的
std::priority_queue和 Java 的PriorityQueue底层均由堆结构实现。