堆
堆是一种完全二叉树形式的特殊数据结构,分为大顶堆、小顶堆;父节点值分别大于 / 小于等于子节点,适合快速获取最值,底层常用数组存储,核心操作是上浮、下沉,常用来实现优先队列、堆排序。
堆(Heap) 是计算机科学中一种非常经典且高效的 基于树状结构 的特殊数据结构。它在优先队列、排序算法(堆排序)以及图算法(如 Dijkstra 算法)中扮演着极其重要的角色。
堆(Heap) 是一种基于 完全二叉树(Complete Binary Tree) 实现的高效数据结构。
在逻辑结构上,它满足以下两个核心特征:
-
结构特性(完全二叉树):除了最后一层外,其余各层的节点数均达到最大值;而在最后一层,所有节点都尽可能地紧靠在最左侧。
-
堆属性(Heap Property):父节点与子节点之间存在着固定的关系。根据这种顺序关系的不同,堆主要分为以下两类:
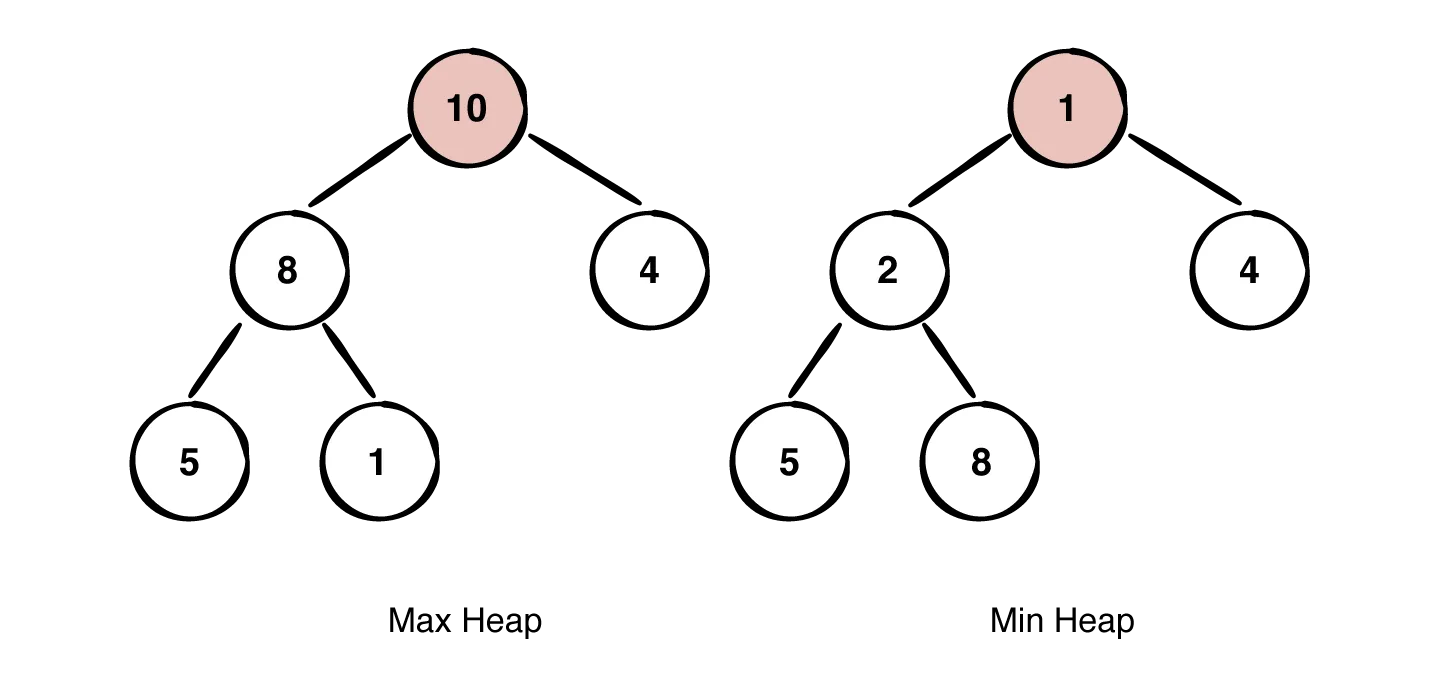
- 大顶堆 / 最大堆 (Max-Heap):每个父节点的值都 大于或等于 其任意子节点的值。因此,根节点(堆顶)始终包含整个堆中的 最大值。常用于堆排序(升序)和求 Top-K 大元素等场景。
- 小顶堆 / 最小堆 (Min-Heap):每个父节点的值都 小于或等于 其任意子节点的值。因此,根节点(堆顶)始终包含整个堆中的 最小值。常用于实现优先队列、Dijkstra 最短路径算法以及求 Top-K 小元素等场景。
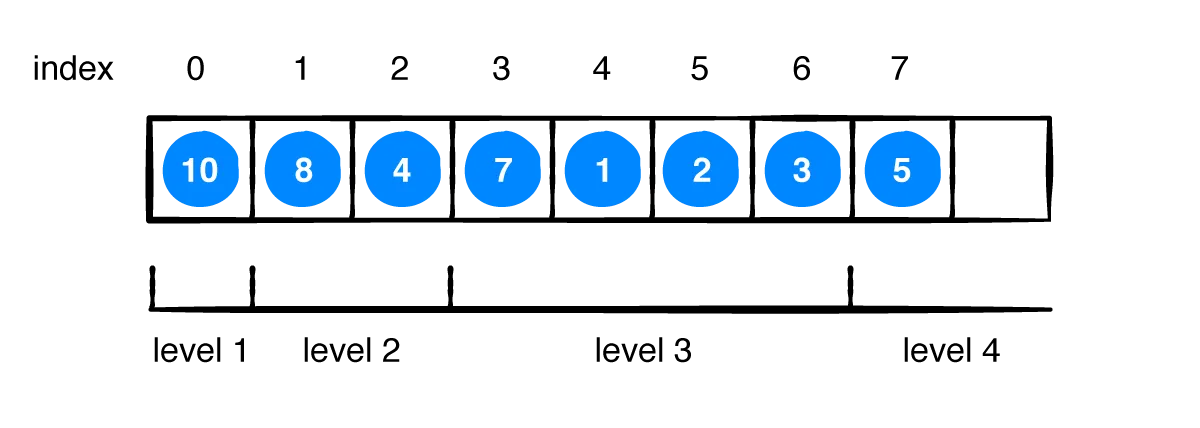
虽然堆在逻辑上是一棵二叉树,但在实际物理内存中,它通常 直接用数组(Array)存储,而不需要像普通二叉树那样使用指针。
依靠完全二叉树的性质,节点在数组中的索引(以 0 为起始下标)天然具备如下数学规律:
- 对于索引为 的节点:
- 左子节点 索引:
- 右子节点 索引:
- 父节点 索引:
堆的核心在于维护其“性质”。每次插入或删除元素后,都需要进行调整:
在堆中插入新元素时,需要通过 向上调整(Sift-Up / Heapify-Up) 机制来维护堆的结构与属性。
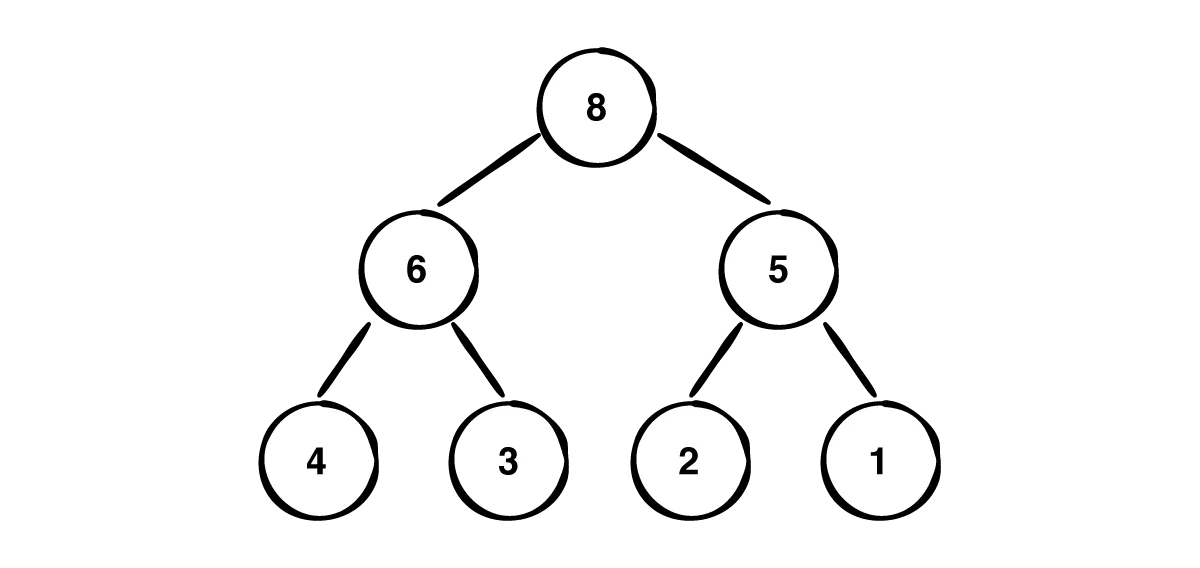
以下以向最大堆(Max-Heap)中插入元素 7 为例,展示完整的插入步骤:
-
追加至末尾
根据完全二叉树的结构要求,将新元素
7添加到堆的最后一个叶子节点位置(即数组末尾)。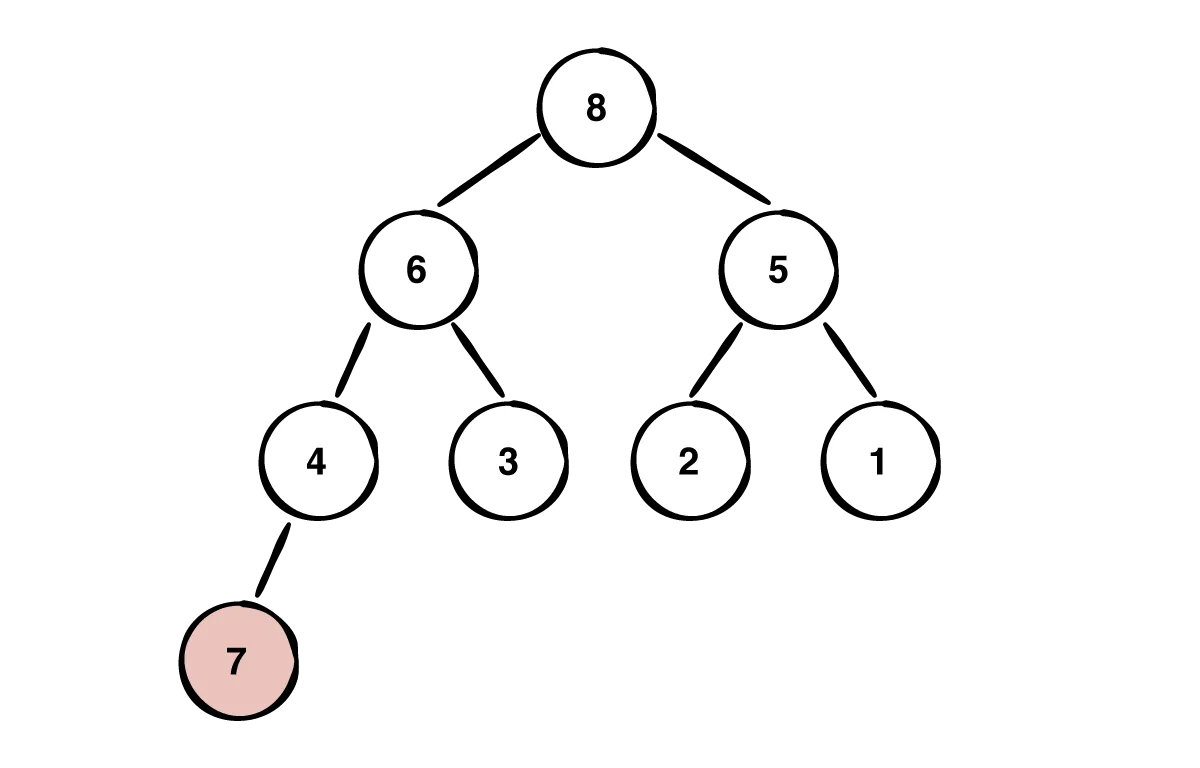
-
第一次向上调整
比较
7与其父节点4的大小。因 ,打破大顶堆规则,将7与4交换位置,7上浮一层。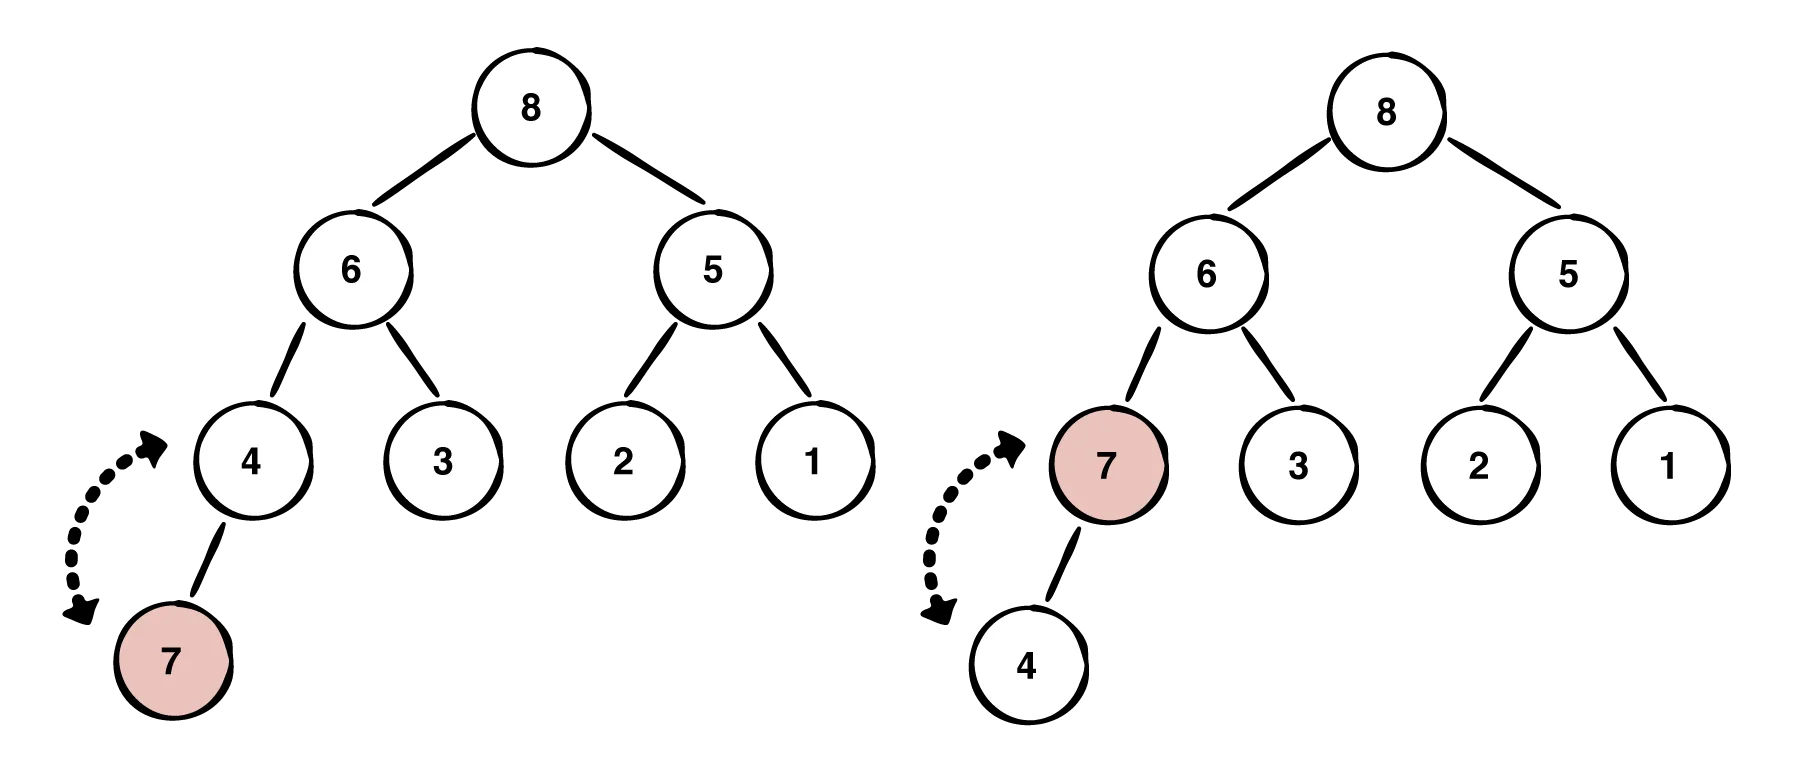
-
第二次向上调整
继续比较
7与其新的父节点6的大小。因 ,再次将7与6交换位置,7继续上浮。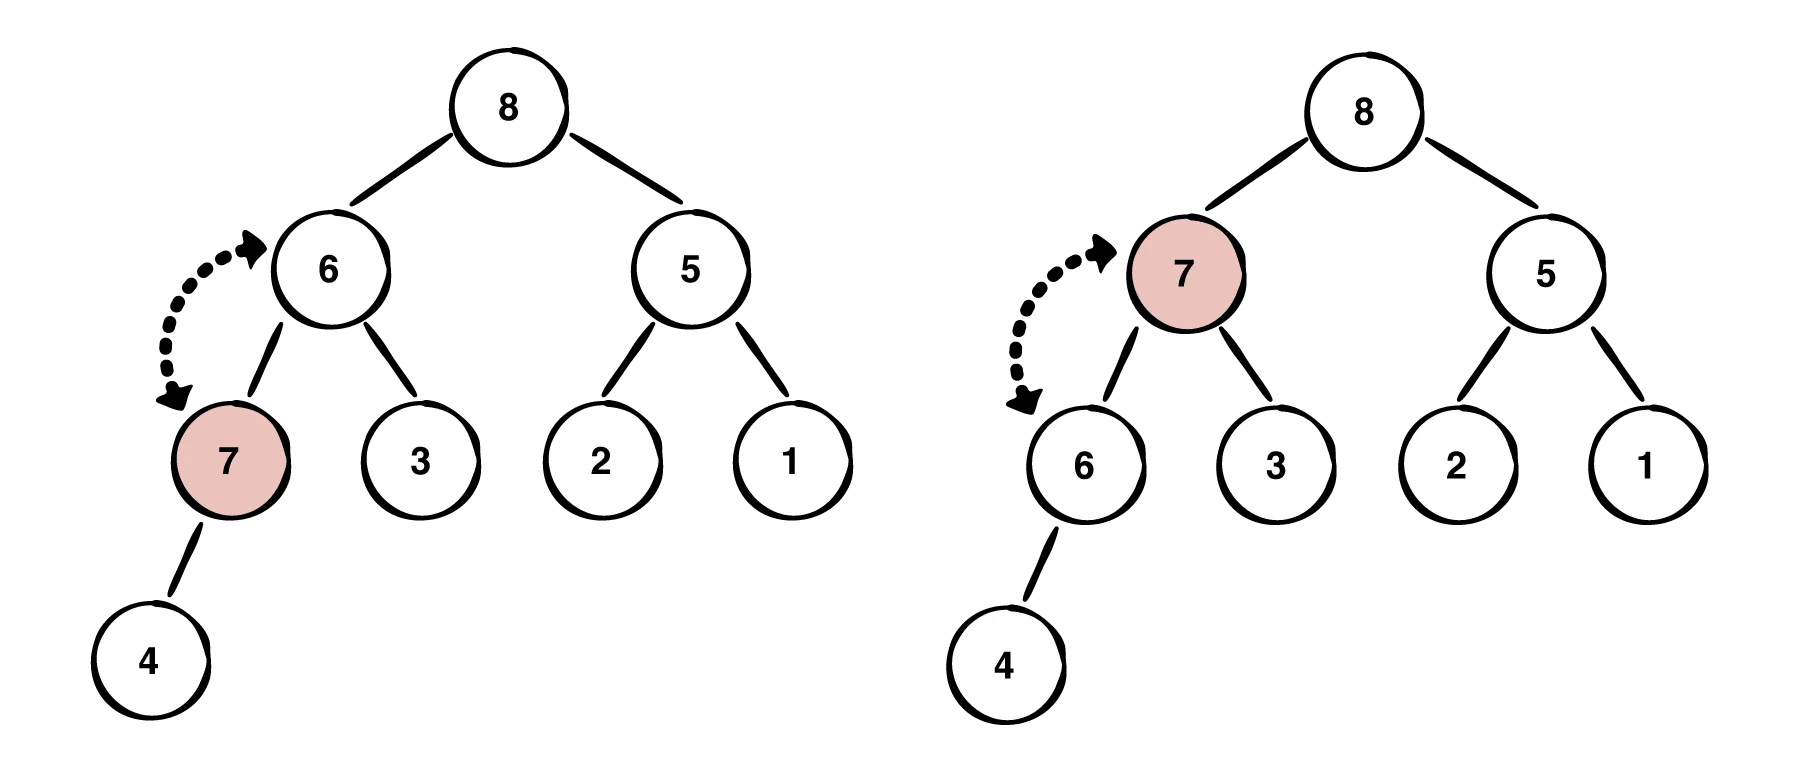
-
再次比较父节点
继续将
7与其新的父节点(根节点8)进行比较。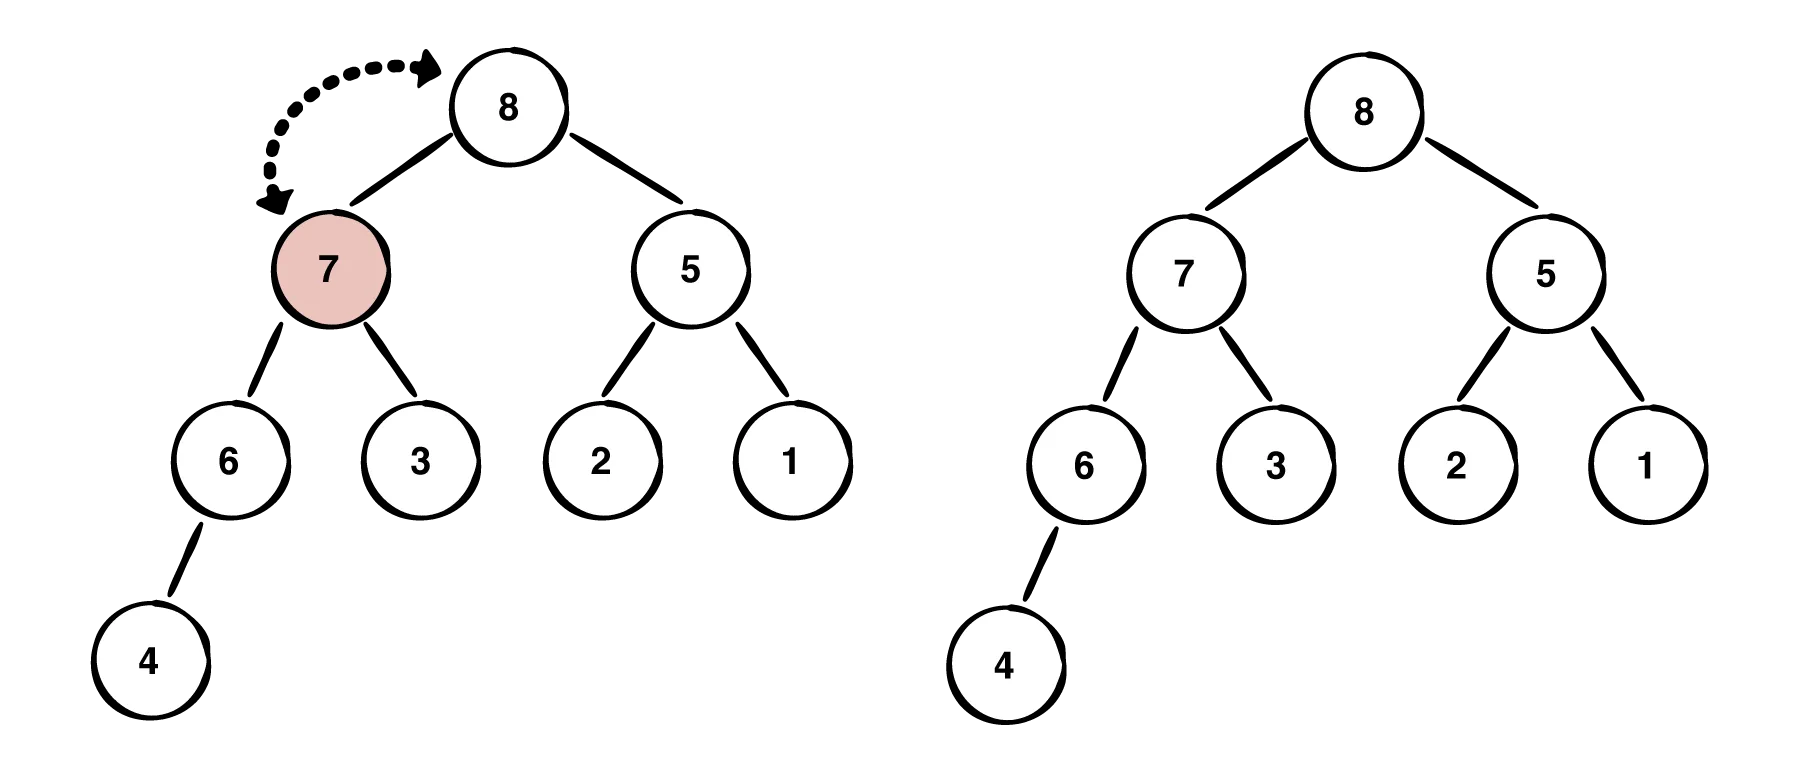
-
满足规则,完成插入
因 ,满足父节点大于等于子节点的堆属性,上浮调整终止,堆重新恢复平衡。
// 向上调整:不断与父节点比较并交换,直到满足大顶堆性质void siftUp(int i) {    while (i > 0) {        int parent = (i - 1) / 2; // 计算父节点下标
        // 若当前节点大于父节点,说明破坏了堆属性,进行交换        if (heap[i] > heap[parent]) {            std::swap(heap[i], heap[parent]);            i = parent; // 跟踪节点上升到父节点位置,继续向上比较        } else {            break; // 已经满足堆属性,提前终止        }    }}
// 插入接口void push(int val) { heap.push_back(val); // 1. 追加到数组末尾(维持完全二叉树结构) siftUp(heap.size() - 1); // 2. 对新插入的叶子节点执行向上调整}在堆中,删除操作通常指的是弹出堆顶元素(最大值或最小值)。弹出后,需要通过 向下调整(Sift-Down / Heapify-Down) 机制来恢复堆的结构与属性。
以下以最大堆(Max-Heap)为例,展示删除堆顶的完整步骤:
-
交换与切除
将堆顶元素
10与末尾叶子节点3交换位置,随后弹出并移除位于末尾的10。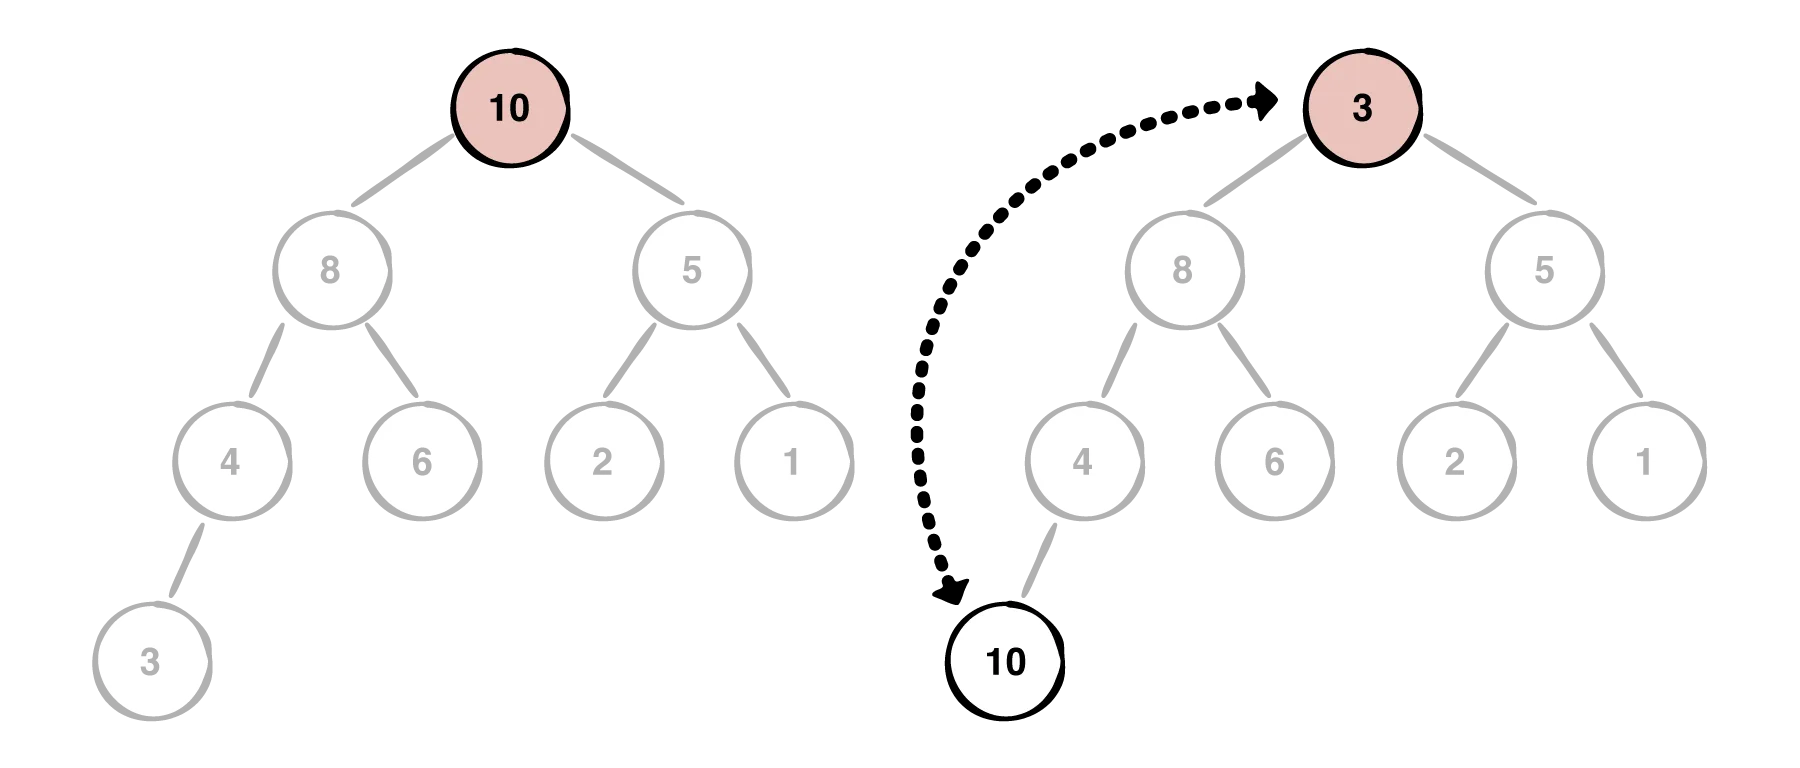
-
定位下沉目标
新堆顶
3破坏了堆属性,检查其左右子节点(8和5),锁定其中较大的子节点8。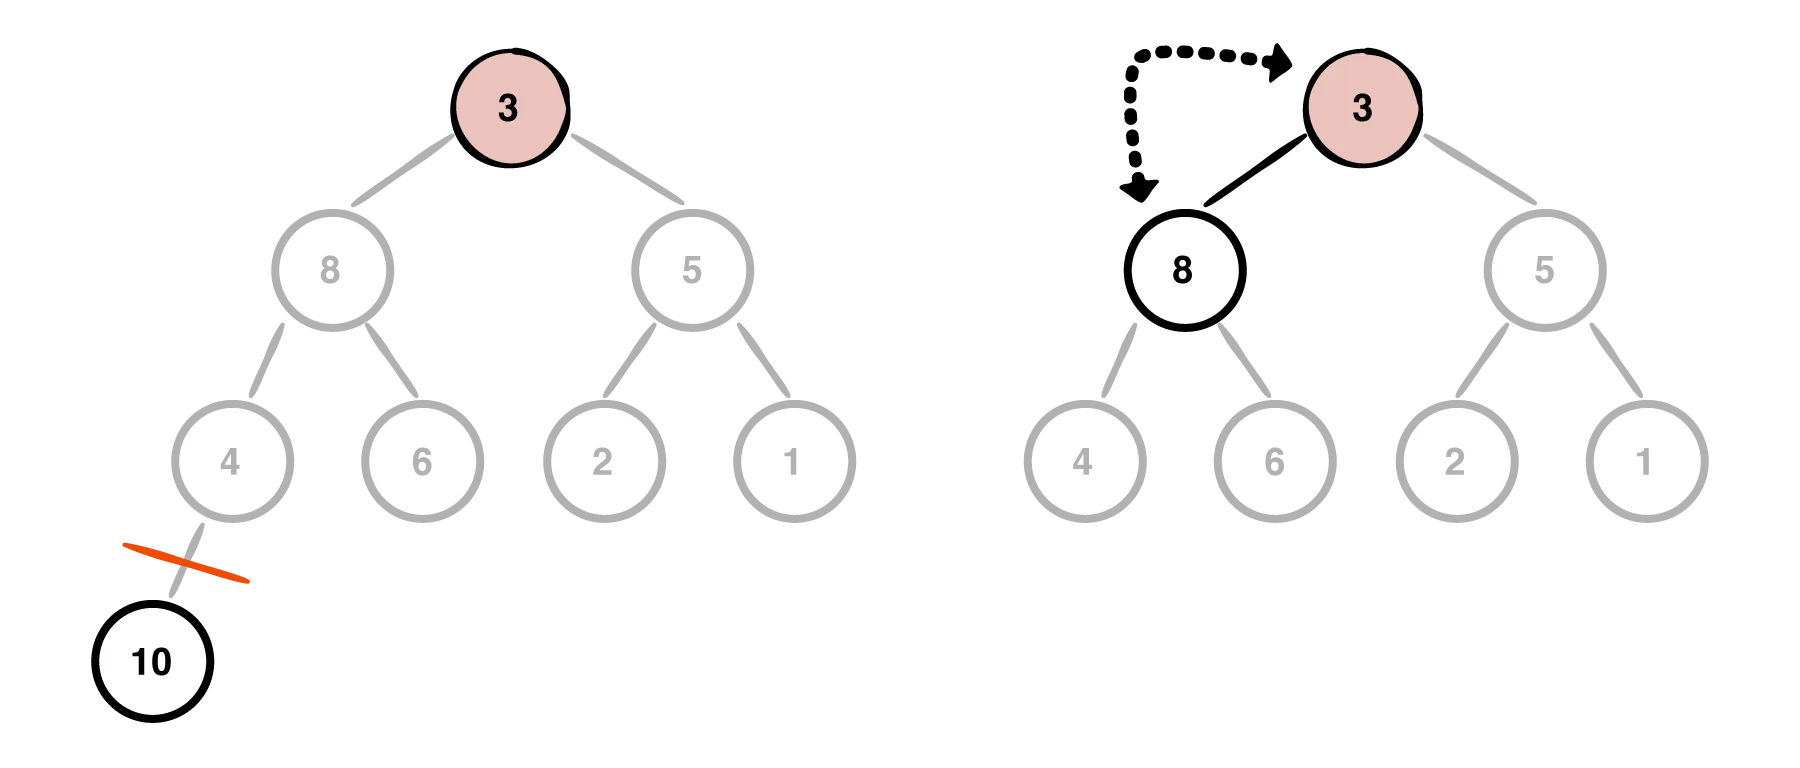
-
第一次下沉
因 ,将
3与8交换位置。8升为新堆顶,3下沉一层。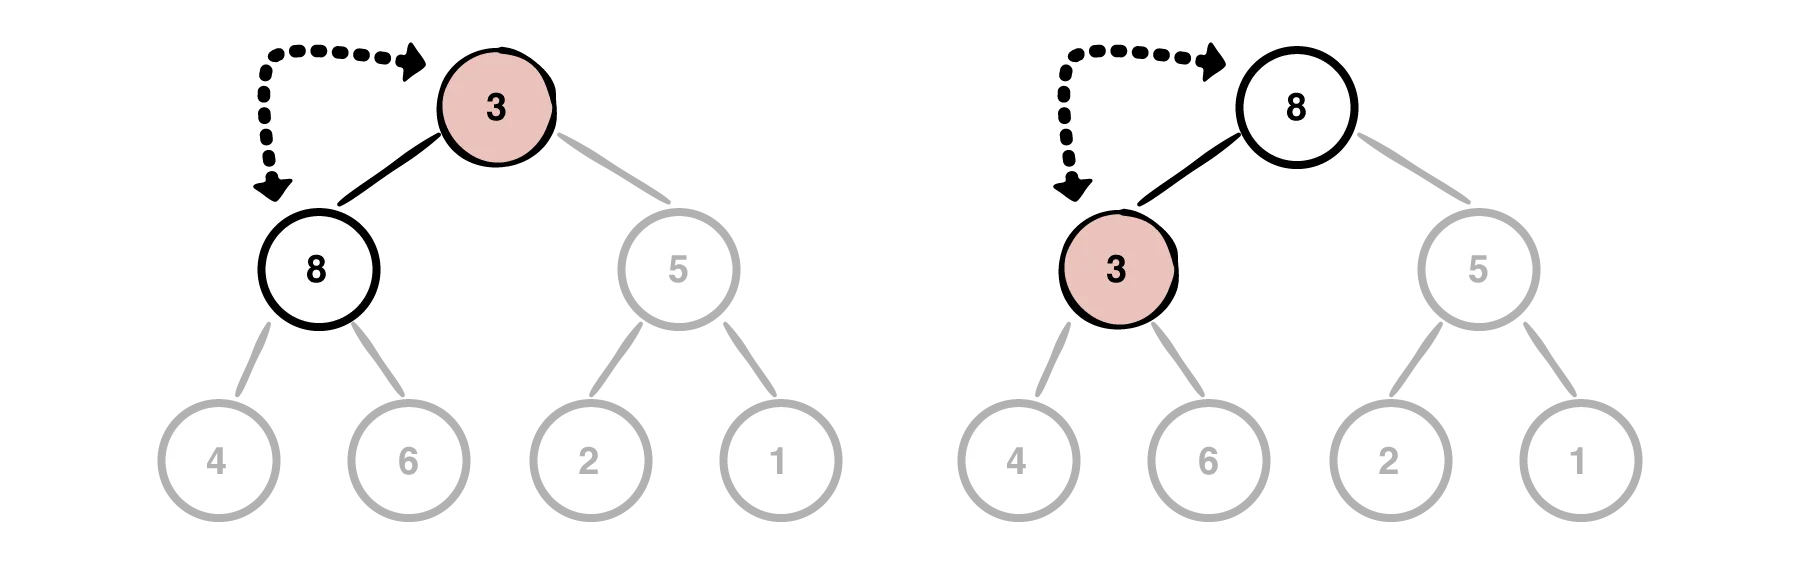
-
再次定位目标
检查来到新位置的
3的左右子节点(4和6),锁定其中较大的子节点6。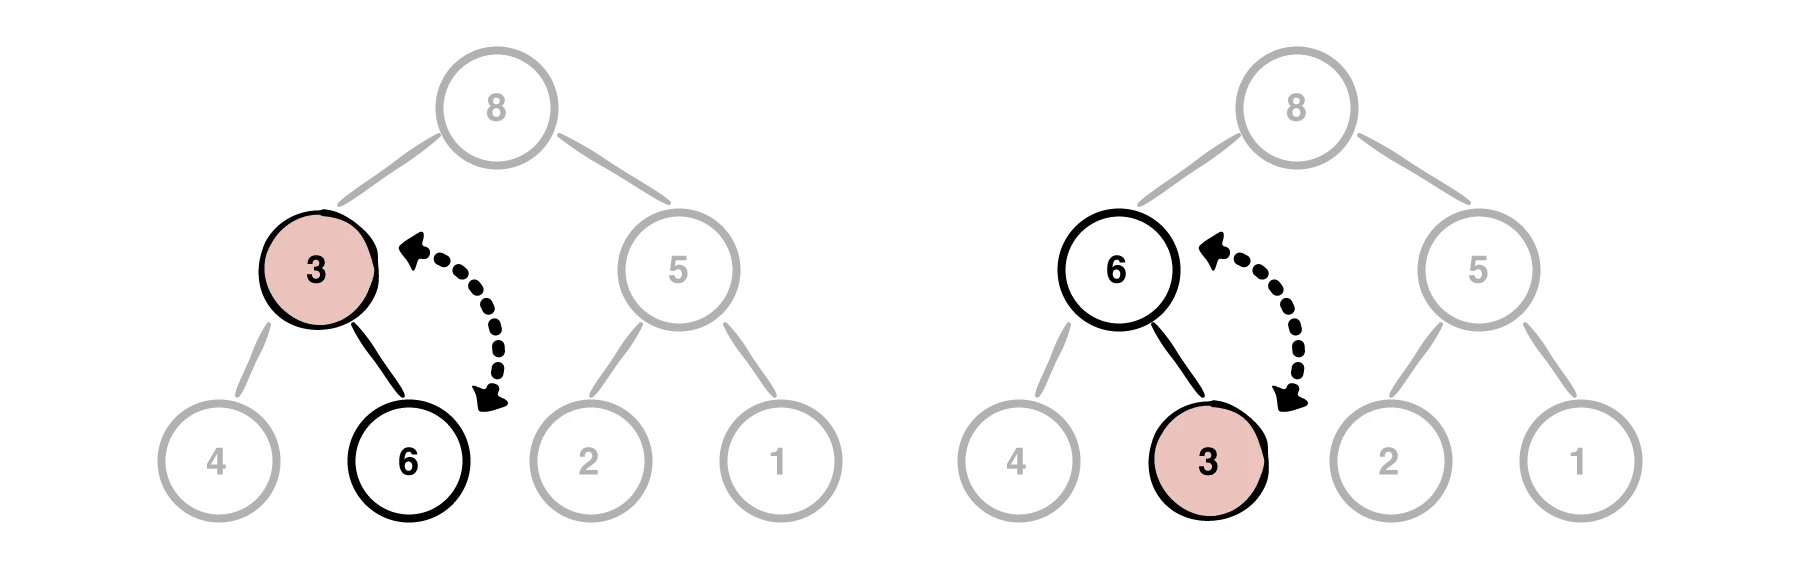
-
第二次下沉(完成调整)
因 ,将
3与6再次交换。此时3已到达叶子节点,向下调整结束,堆重新恢复平衡。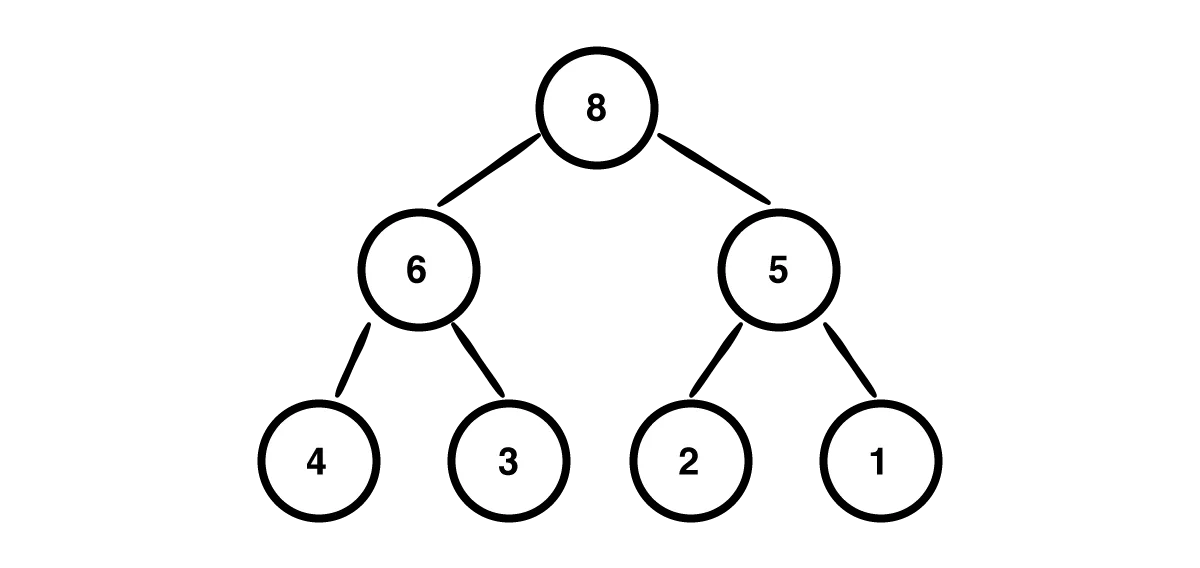
// 向下调整:不断与较大的子节点比较并交换,直到满足大顶堆性质void siftDown(int i) {    int size = heap.size();
    // 当存在左子节点时继续调整(即当前节点不是叶子节点)    while (2 * i + 1 < size) {        int left = 2 * i + 1;      // 左子节点下标        int right = 2 * i + 2;     // 右子节点下标        int largest = i;          // 暂定当前节点为最大者
        // 找出 当前节点、左子节点、右子节点 中的最大值下标        if (heap[left] > heap[largest]) {            largest = left;        }        if (right < size && heap[right] > heap[largest]) {            largest = right;        }
        // 若最大者不是当前节点,说明破坏了堆属性,需要向下交换        if (largest != i) {            std::swap(heap[i], heap[largest]);            i = largest; // 跟踪节点下沉到子节点位置,继续向下比较        } else {            break; // 已经满足堆属性,提前终止        }    }}
// 删除堆顶接口void pop() {    if (heap.empty()) return;
    heap[0] = heap.back(); // 1. 用末尾元素覆盖堆顶(原堆顶被替换/删除)    heap.pop_back();       // 2. 移除数组末尾节点
if (!heap.empty()) { siftDown(0); // 3. 对新的堆顶执行向下调整 }}从堆的任意位置删除元素时,通用做法是:用数组末尾的元素覆盖待删除位置的元素,然后移除末尾节点。
由于替换上来的末尾元素大小不确定,可能破坏堆属性,因此需要进行双向调整(Sift-Up 或 Sift-Down):
如下图所示,假设我们要删除值为 5 的节点:
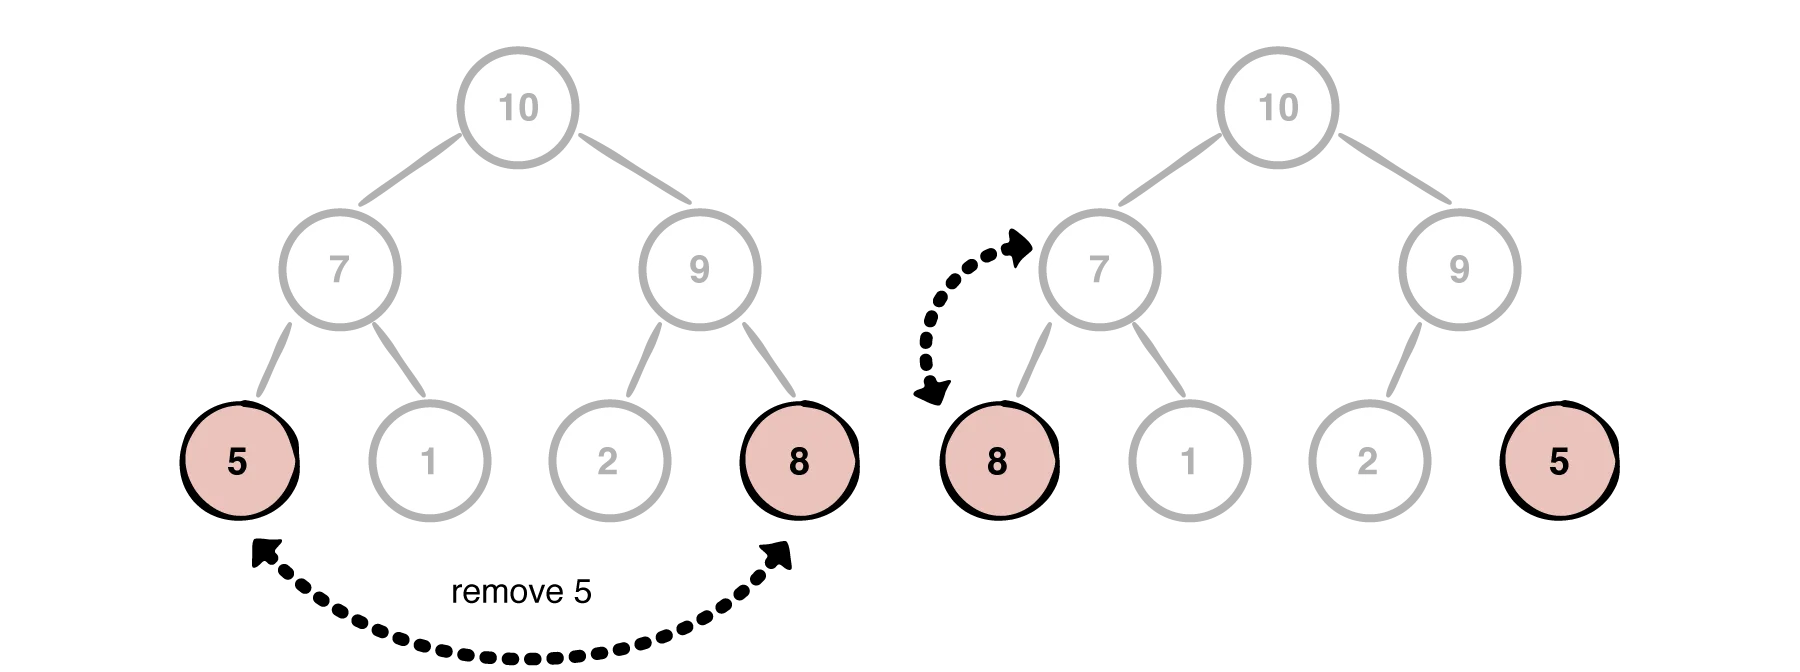
- 覆盖与切除:将末尾节点
8移动到待删除节点5的位置,并切除原末尾节点5。 - 向上比较:检查新位置上的
8与其父节点7的大小。 - 向上调整:因 ,打破大顶堆属性,将
8与7交换位置(Sift-Up)。
如下图所示,假设我们要删除值为 7 的节点:
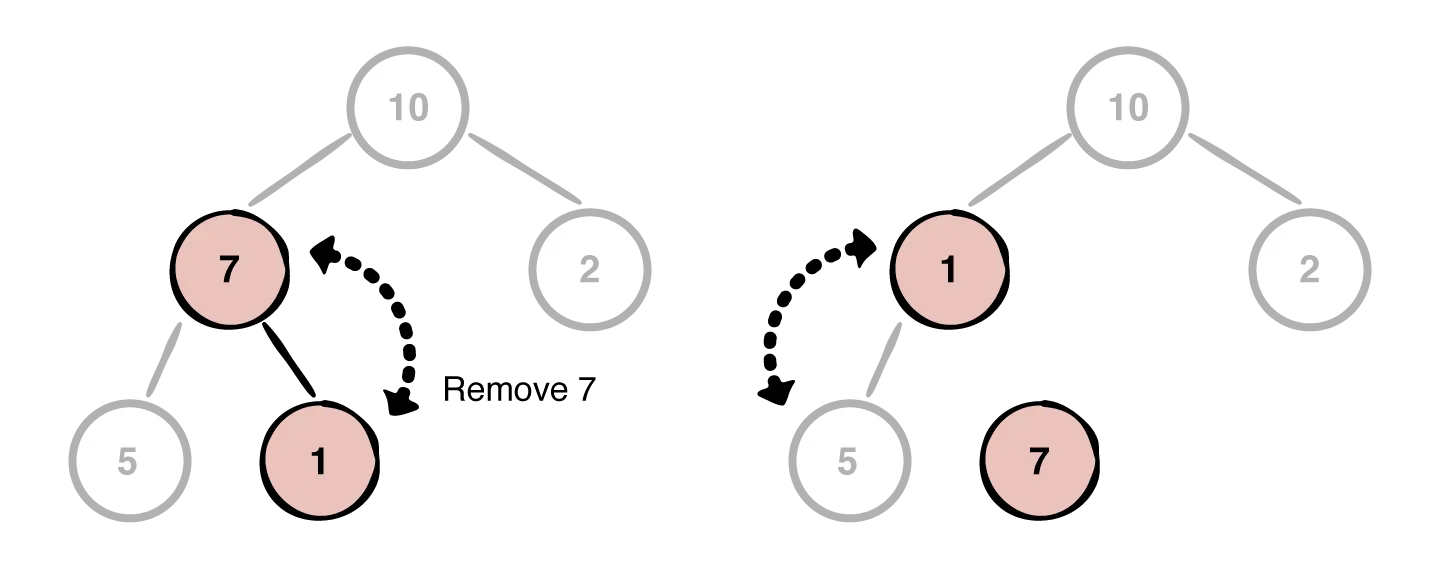
- 覆盖与切除:将末尾节点
1移动到待删除节点7的位置,并切除原末尾节点7。 - 定位子节点:检查新位置上的
1的子节点(只有左子节点5)。 - 向下调整:因 ,打破大顶堆属性,将
1与5交换位置(Sift-Down),1下沉为叶子节点。
// 删除指定下标 index 处的元素void removeAt(int index) {    if (index < 0 || index >= heap.size()) return;
    // 1. 如果刚好是最后一个元素,直接弹出    if (index == heap.size() - 1) {        heap.pop_back();        return;    }
    // 2. 用末尾元素覆盖当前位置,并移除末尾元素    heap[index] = heap.back();    heap.pop_back();
// 3. 尝试向下或向上调整(只会触发其中一种) siftDown(index); siftUp(index);}- 优先队列(Priority Queue)
- 普通队列遵循“先进先出”,而优先队列每次出队的是“优先级最高”的元素。C++ 的
std::priority_queue和 Java 的PriorityQueue底层都是基于堆实现的。
- 普通队列遵循“先进先出”,而优先队列每次出队的是“优先级最高”的元素。C++ 的
- 堆排序(Heap Sort)
- 一种原地的、不稳定排序算法,时间复杂度在最好、最坏、平均情况下均为 。
- 海量数据 Top-K 问题
- 例如:在 10 亿个整数中找出最大的前 100 个数。
- 解法:维护一个大小为 的 小顶堆,遍历数据并与堆顶比较,最终堆内留下的就是最大的 100 个数。空间复杂度仅需 。
- 合并 个有序链表 / 流数据合并
- 利用小顶堆维护每个链表的当前头节点,每次取出最小值,时间复杂度为 。