桶排序
桶排序将数据按数值范围划分到若干个桶内,每个桶内部再使用其他排序算法排序,最后依次合并所有桶的元素得到有序序列;平均时间复杂度 O(n),适合数据分布均匀的场景,需要额外开辟桶空间,属于稳定排序。
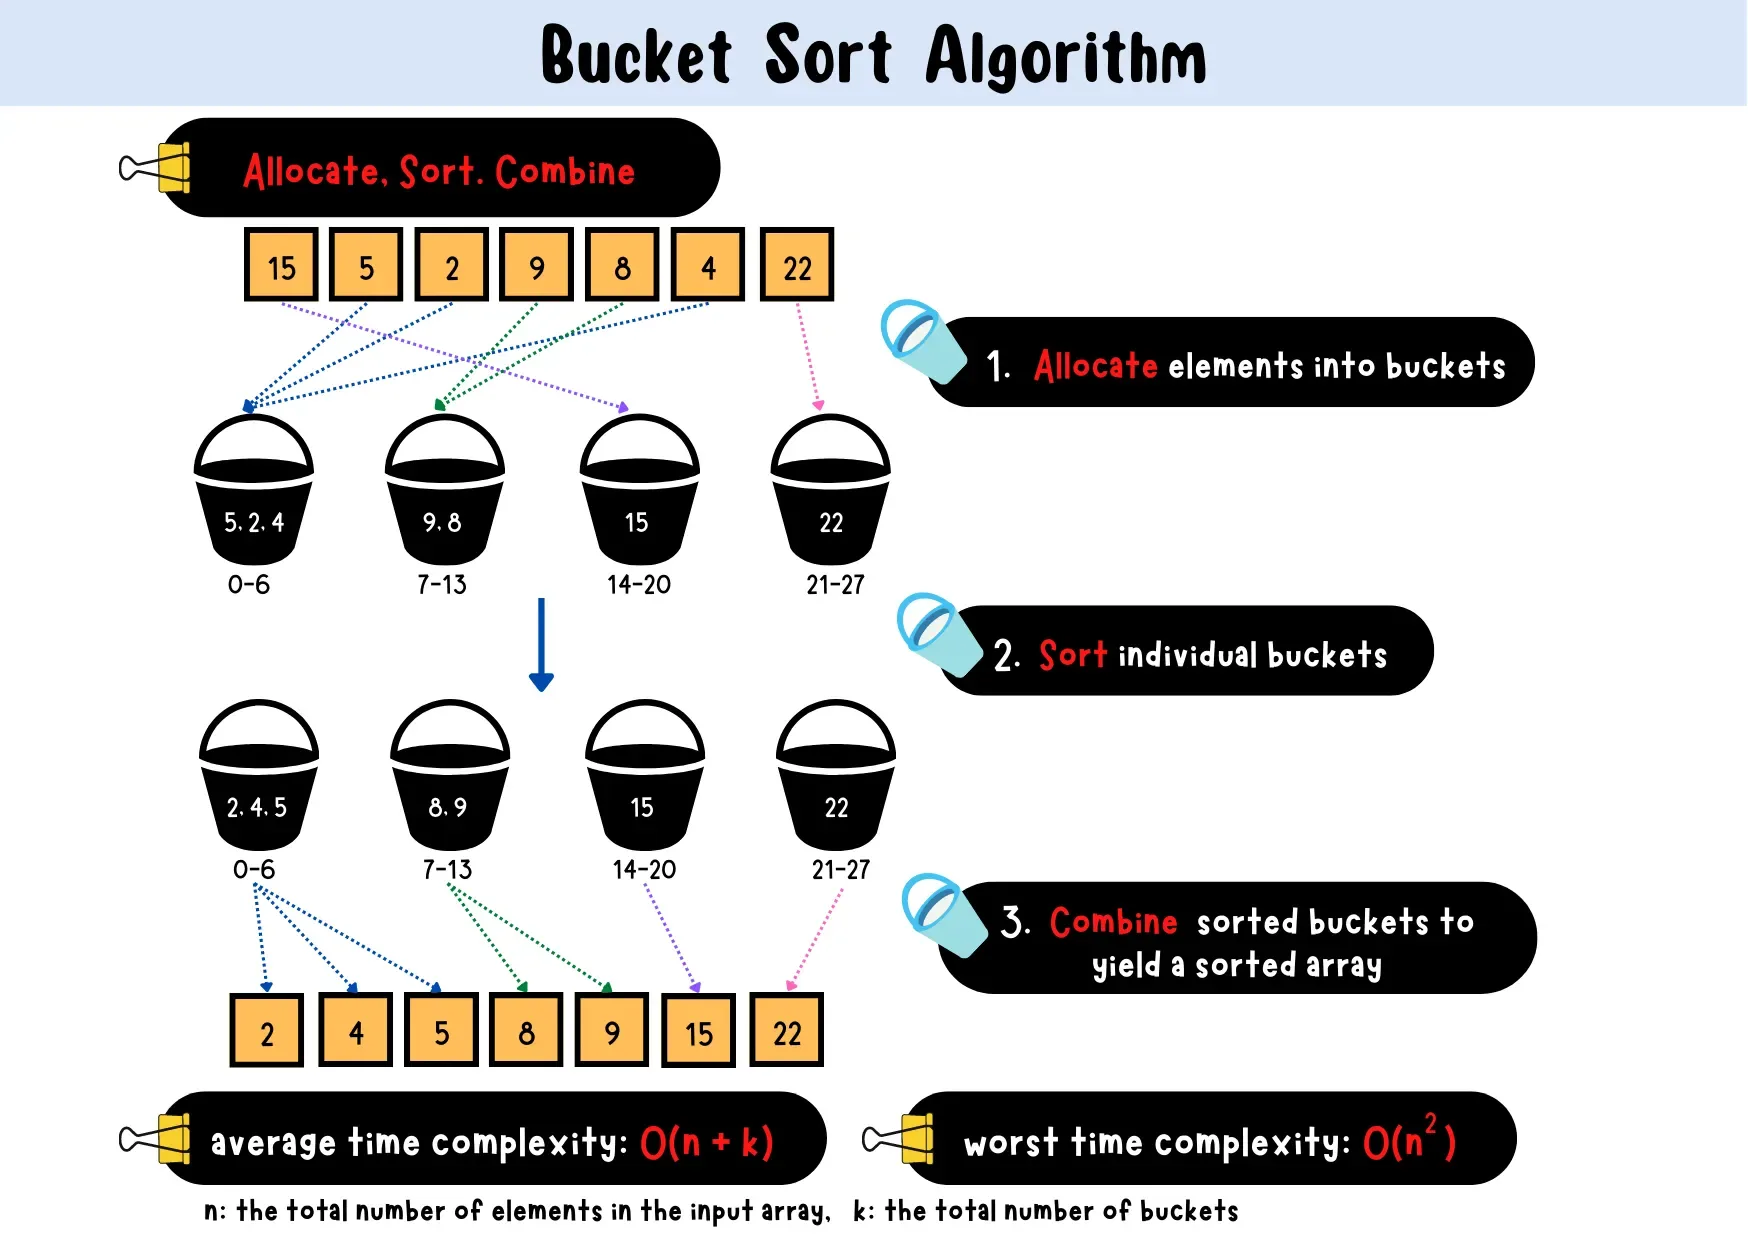
桶排序(Bucket Sort) 是一种分治思想的排序算法。它的核心理念是将数组分到有限数量的 桶(Bucket) 里,每个桶再分别进行排序(可以使用其他排序算法,或继续递归使用桶排序),最后按顺序把各个桶里的元素合并起来。
如果输入的数据分布均匀,桶排序可以达到线性时间复杂度 。
桶排序的具体步骤可以分为以下 4 步:
- 初始化桶:根据待排序数据的范围,确定桶的数量和区间大小,创建空桶。
- 分配数据:遍历原始数组,利用映射函数(Hash 函数)计算出每个元素应该放入哪一个桶中。
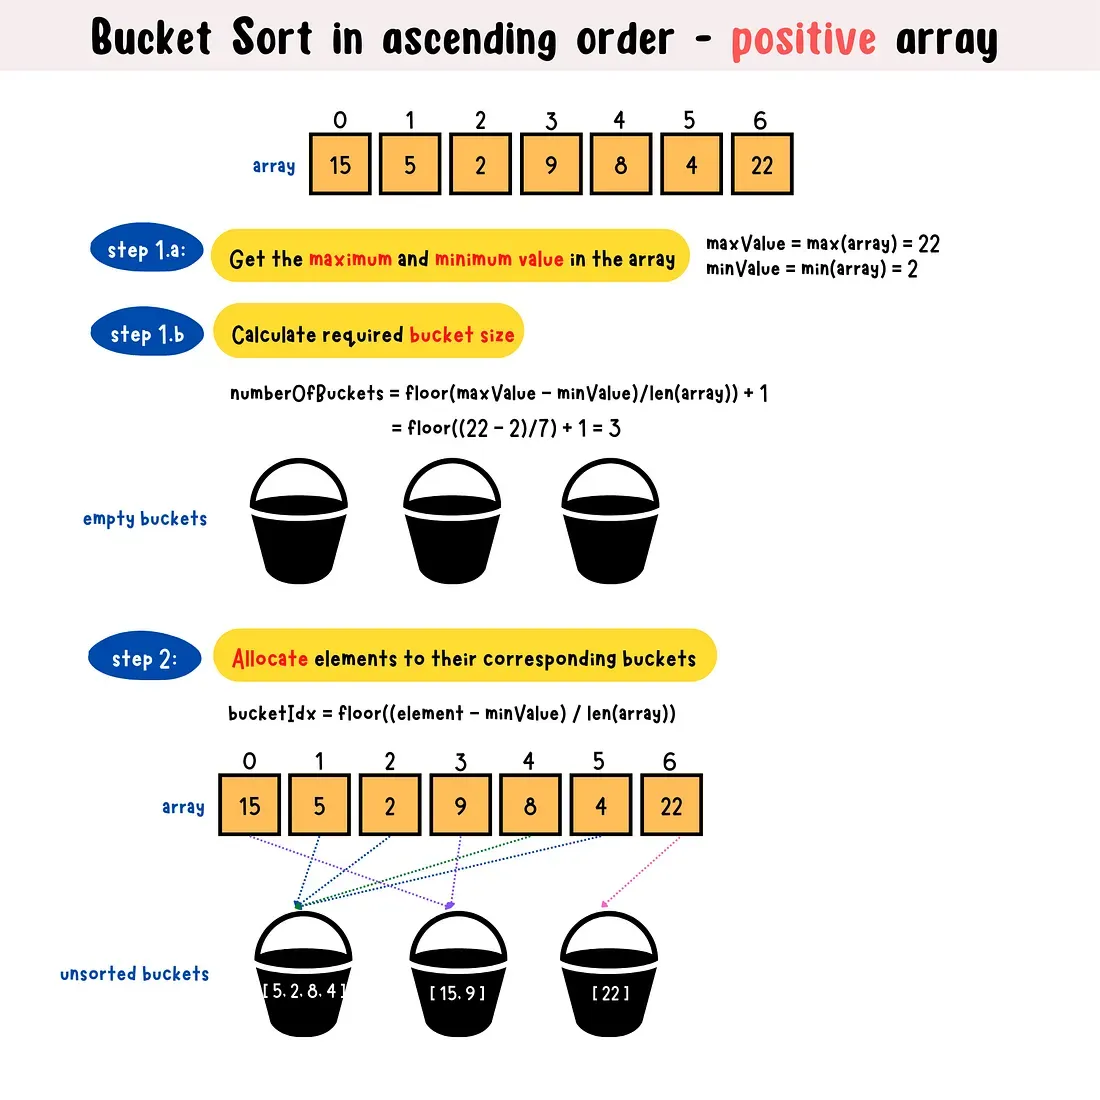
先获取数组最值计算桶总数,通过索引映射把原始元素分散到各个桶中;此时桶内数据无序,后续需要对每个桶内部排序。 - 桶内排序:对每个非空的桶独立进行排序(通常使用插入排序、快速排序等)。
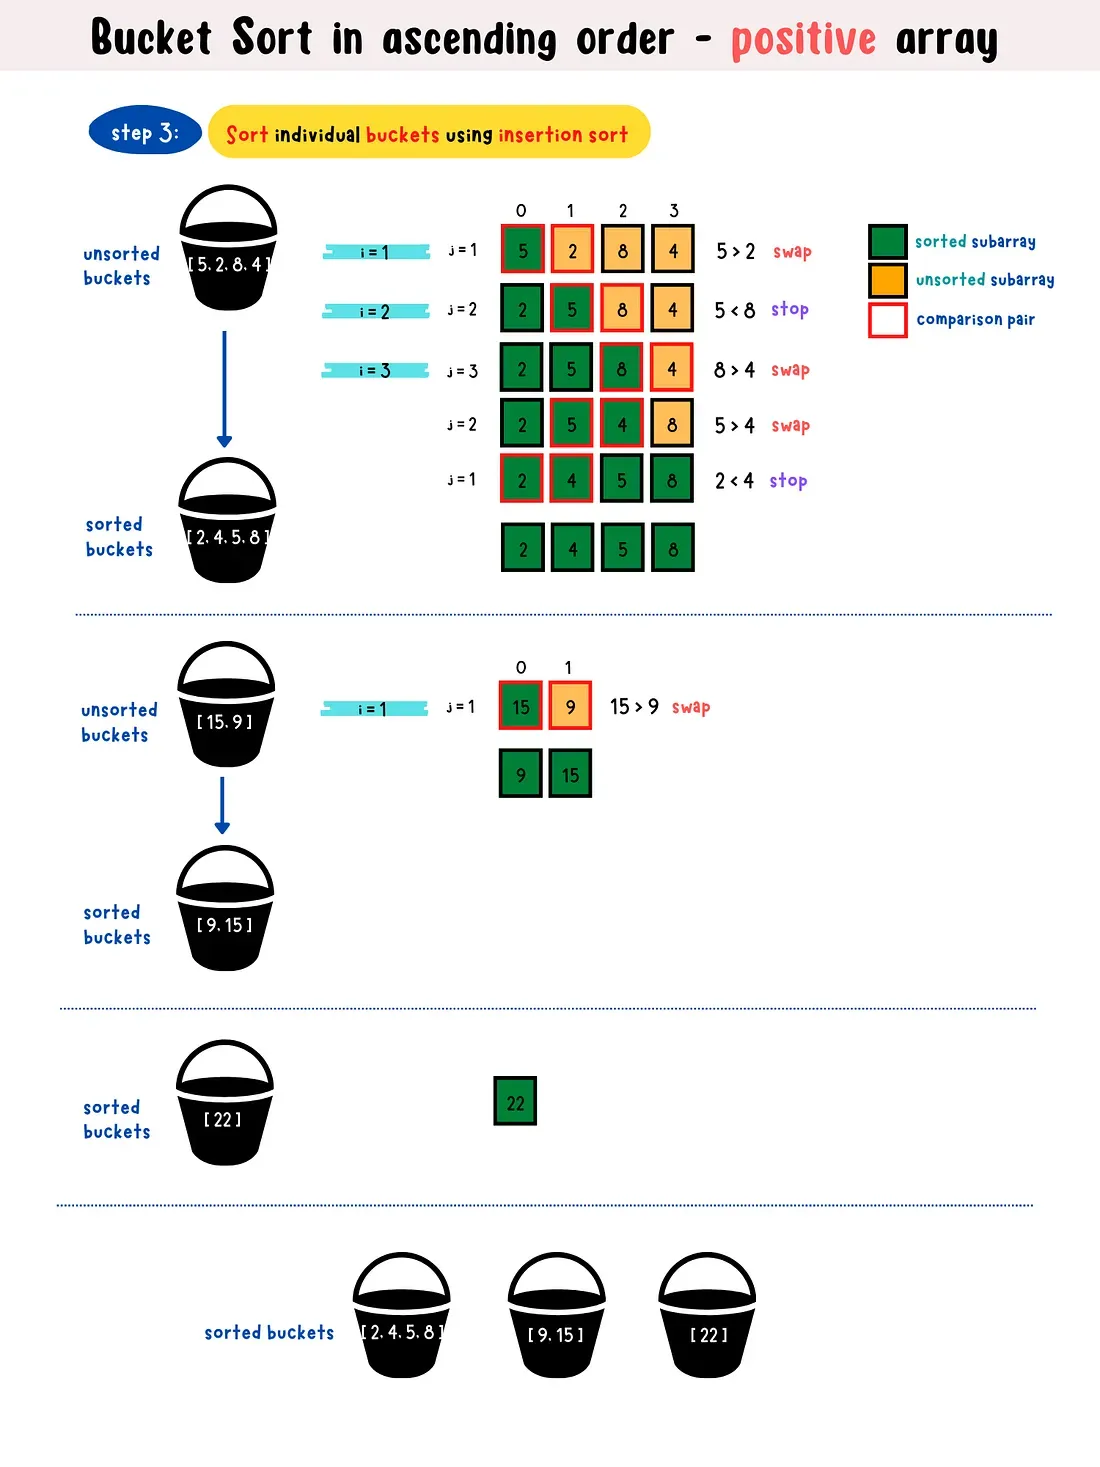
分发完成后每个桶内部仍是乱序;选用插入排序对每个桶独立排序。桶内数据量小,插入排序效率表现较好;全部桶排序完成后,下一步依次拼接所有桶即可得到完整有序数组。 - 合并结果:按照桶的顺序,依次取出各个桶中的元素,组合成最终的有序序列。
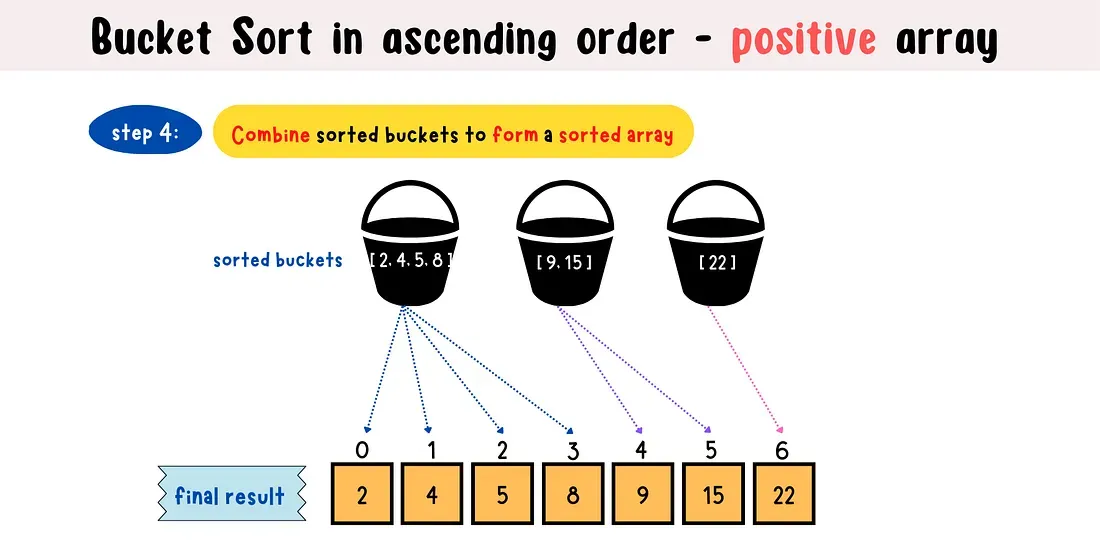
各桶已经有序,桶与桶之间天然满足大小关系;直接按桶顺序依次取出全部元素,不需要跨桶比较,即可得到全局有序数组。
| 指标 | 复杂度 / 属性 | 说明 |
|---|---|---|
| 最好时间复杂度 | 数据均匀分布,每个桶内元素极少,排序耗时接近 | |
| 最坏时间复杂度 | 所有元素都被分配到了同一个桶中(取决于桶内使用的排序算法) | |
| 平均时间复杂度 | 为元素个数, 为桶的数量 | |
| 空间复杂度 | 需要额外的空间来存储桶及桶内的元素 | |
| 稳定性 | 稳定 | 是否稳定取决于桶内排序所使用的算法(如使用插入排序则稳定) |
以下是一个用 C++ 实现的典型桶排序(桶内使用内置排序/插入排序思想):
#include <iostream>#include <vector>#include <algorithm> // 用于 std::sort
// 桶排序函数void bucketSort(std::vector<float>& arr) {    int n = arr.size();    if (n <= 1) return;
    // 1. 创建 n 个空桶    std::vector<std::vector<float>> buckets(n);
    // 2. 将数组中的元素分配到不同的桶中    for (int i = 0; i < n; ++i) {        // 利用映射函数:index = n * arr[i] 计算桶索引        int bucketIndex = n * arr[i];
        // 边界防护:防止元素等于 1.0 时索引越界        if (bucketIndex >= n) {            bucketIndex = n - 1;        }
        buckets[bucketIndex].push_back(arr[i]);    }
    // 3. 对每个桶分别进行排序    for (int i = 0; i < n; ++i) {        // std::sort 底层在元素较少时会自动使用插入排序        std::sort(buckets[i].begin(), buckets[i].end());    }
    // 4. 将所有桶中的元素依次拼接回原数组    int index = 0;    for (int i = 0; i < n; ++i) {        for (float val : buckets[i]) {            arr[index++] = val;        }    }}
int main() {    // 测试数据(取值范围在 0 ~ 1 之间的浮点数)    std::vector<float> arr = {0.897, 0.565, 0.656, 0.1234, 0.665, 0.3434};
    std::cout << "排序前: ";    for (float x : arr) {        std::cout << x << " ";    }    std::cout << "\n";
    // 执行桶排序    bucketSort(arr);
    std::cout << "排序后: ";    for (float x : arr) {        std::cout << x << " ";    }    std::cout << "\n";
return 0;}- 数据分布均匀:如在 浮点数范围内均匀分布的数据。
- 已知数据边界:能够明确算出数据的极值范围,从而设置合理的映射函数。
- 对数据分布敏感:如果数据极度倾斜(比如 99% 的数据都挤在一个桶里),桶排序会退化为普通的桶内排序算法(如 或 )。
- 额外空间开销大:需要预先分配桶空间,对于极其稀疏的数据可能会浪费大量的内存。
- 计数排序(Counting Sort):可以看作是桶排序的特例,即每个桶的区间大小正好为 1。只适用于整数且范围较小的情况。
- 基数排序(Radix Sort):按“位”(个位、十位、百位)来进行多轮桶排序,适合处理位数固定的大整数或字符串。