快速排序
快速排序基于分治思想,选取一个基准元素,把数组划分成小于基准和大于基准的两部分,再递归对左右子区间继续划分排序;平均时间复杂度\(O(n\log n)\),最坏\(O(n^2)\),属于不稳定排序,不需要额外开辟大量辅助空间。
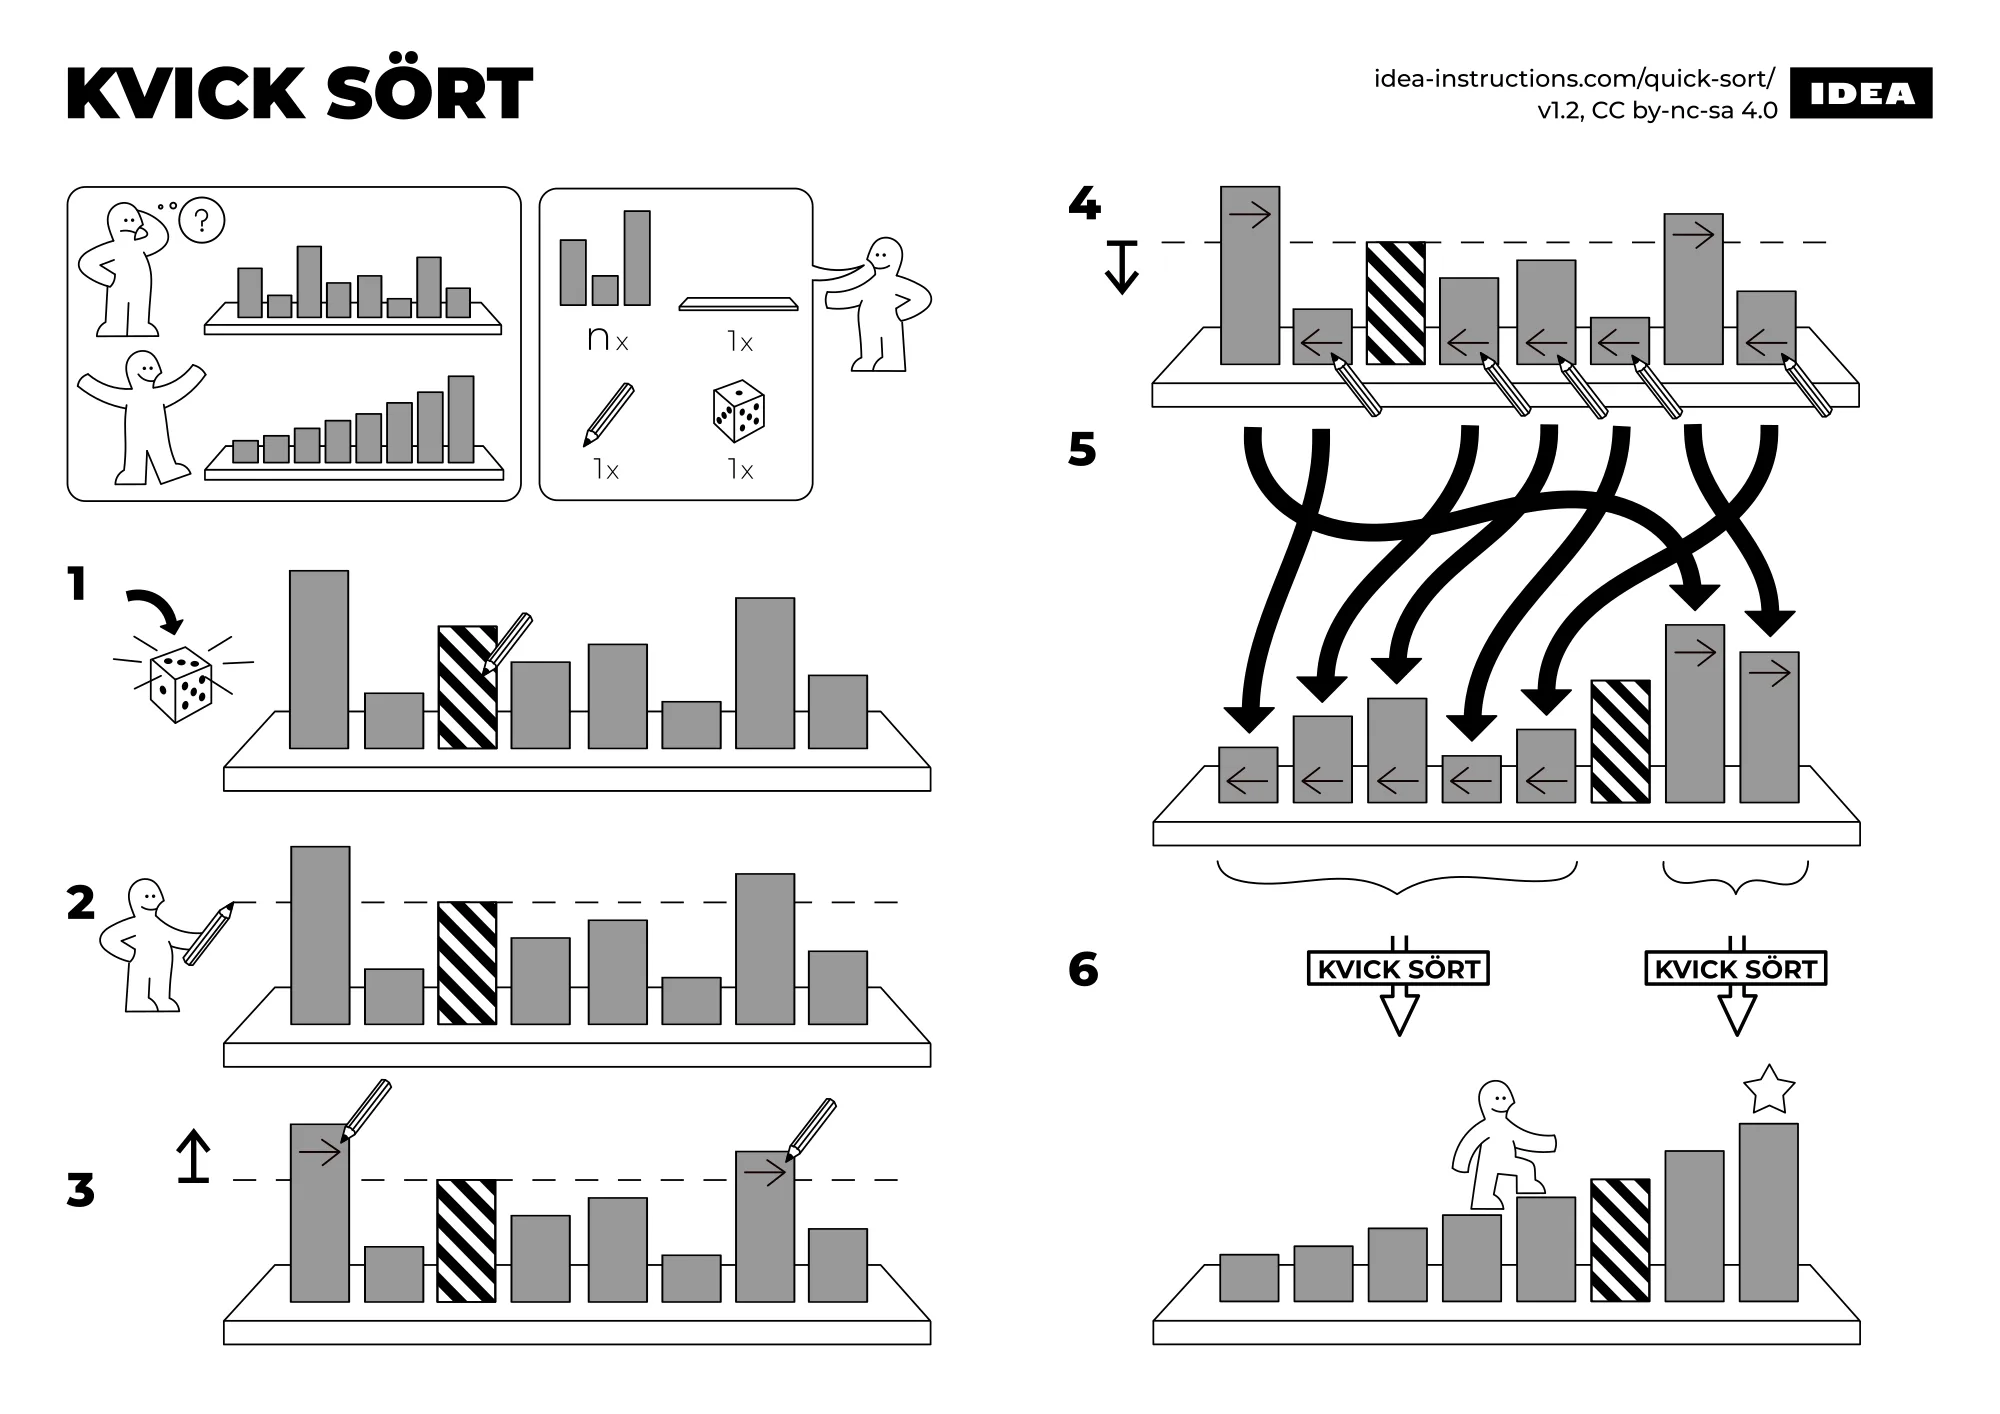
快速排序(Quick Sort) 是由东尼·霍尔(Tony Hoare)在 1960 年提出的一种高效排序算法。它同样基于 分治法(Divide and Conquer),是实际工程应用中最常被选用的内部排序算法之一(如 C++ 的 std::sort 标准库底层核心实现之一)。
与归并排序“先拆分、再合并”不同,快速排序的核心思路是“先做划分、再各自递归”,它直接在原数组上进行元素交换,不需要额外的辅助数组。
快速排序的核心步骤如下:
- 挑选基准值(Pivot): 从数组中挑出一个元素作为“基准”(Pivot)。
- 分区操作(Partition): 重新排序数组,把所有小于基准值的元素移动到基准的左边,所有大于基准值的元素移动到右边(等于基准值的元素放在任意一边均可)。分区完成后,基准值就处于它的最终正确位置。
- 递归排序(Recursion): 递归地对基准值左边的子数组和右边的子数组分别重复上述步骤,直到子数组的长度为 0 或 1(基线条件)。
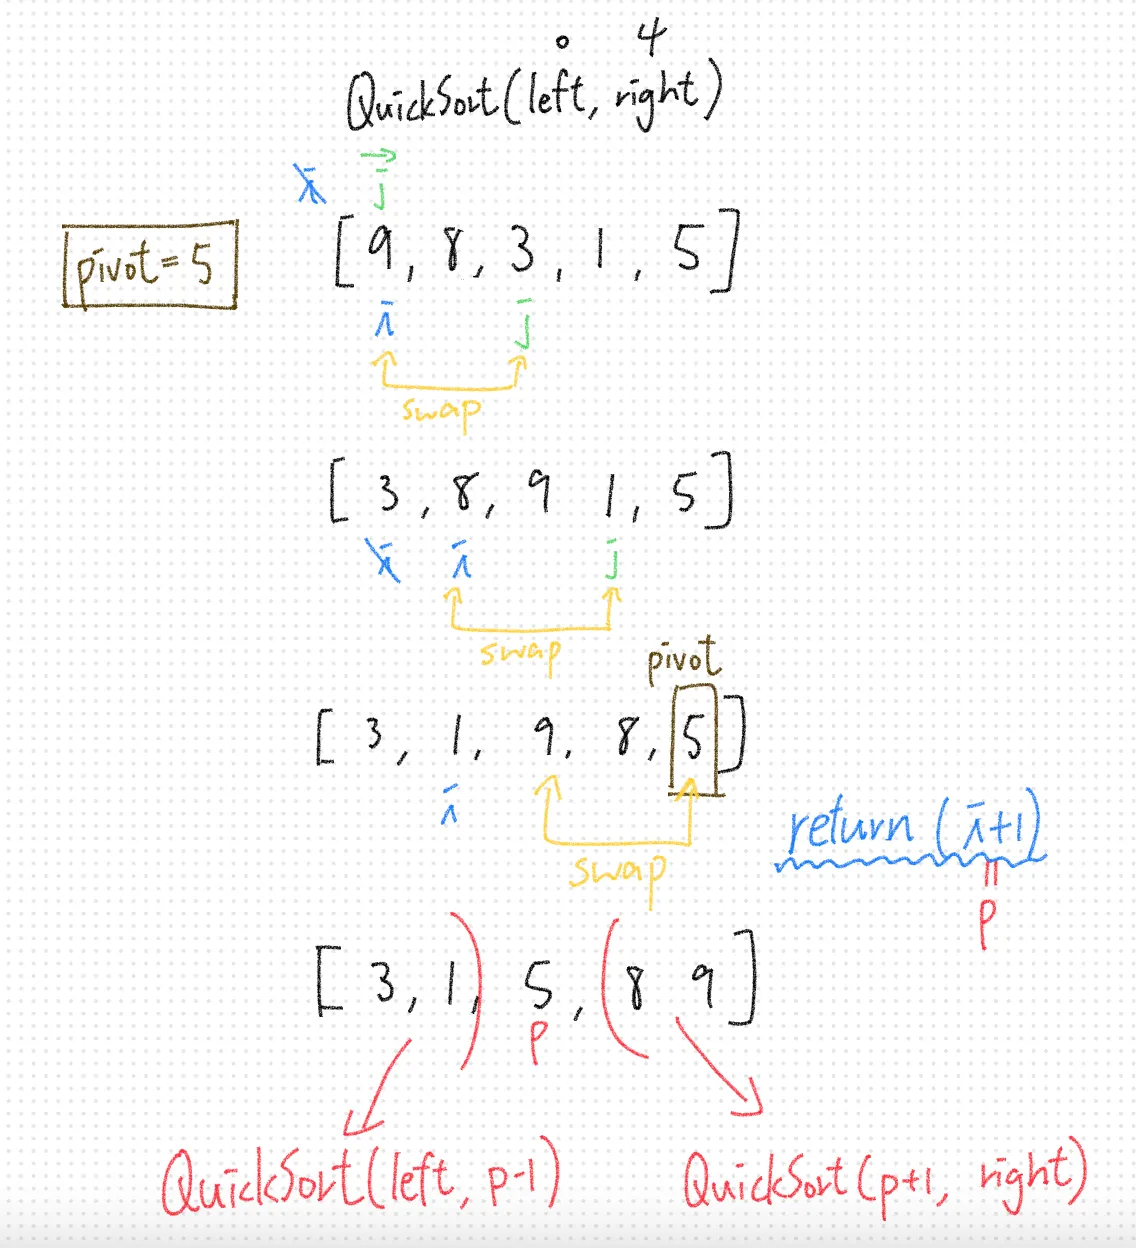
以下是基于 Lomuto 分区方案 的常规递归实现:
#include <iostream>#include <vector>#include <algorithm> // 用于 std::swap
// 分区函数:将小于 pivot 的放在左边,大于 pivot 的放在右边int partition(std::vector<int>& arr, int low, int high) {    // 选取最右侧元素作为基准值    int pivot = arr[high];
    // i 表示小于 pivot 区域的末尾索引    int i = low - 1;
    for (int j = low; j < high; ++j) {        // 如果当前元素小于或等于基准值        if (arr[j] <= pivot) {            i++;            std::swap(arr[i], arr[j]);        }    }    // 将 pivot 放到正确的位置上    std::swap(arr[i + 1], arr[high]);    return i + 1; // 返回 pivot 的最终索引}
// 快速排序主递归函数void quickSort(std::vector<int>& arr, int low, int high) {    if (low < high) {        // pi 为划分后 pivot 的位置索引        int pi = partition(arr, low, high);
        // 分别对 pivot 左右两侧的子数组进行递归排序        quickSort(arr, low, pi - 1);        quickSort(arr, pi + 1, high);    }}
int main() {    std::vector<int> nums = {5, 2, 9, 1, 7, 6, 3};
    std::cout << "排序前: ";    for (int num : nums) std::cout << num << " ";    std::cout << std::endl;
    if (!nums.empty()) {        quickSort(nums, 0, nums.size() - 1);    }
    std::cout << "排序后: ";    for (int num : nums) std::cout << num << " ";    std::cout << std::endl;
return 0;}| 评价维度 | 复杂度/特性 | 详细说明 |
|---|---|---|
| 最好时间复杂度 | 每次划分都能完美地将数组一分为二,递归树深度为 。 | |
| 平均时间复杂度 | 绝大多数随机分布数据下的综合性能极佳,常数系数非常小。 | |
| 最坏时间复杂度 | 当数组完全有序/逆序且每次固定选端点作为 pivot 时,递归退化为单链结构。 | |
| 空间复杂度 | 原地排序(In-place Sort),无需辅助数组;但递归调用栈平均消耗 空间。 | |
| 稳定性 | 不稳定 | 在跨越式交换元素(如与基准交换)的过程中,相同元素的相对顺序可能会被颠倒。 |
因为原始快速排序存在 的退化风险,现代工程实现(如 STL std::sort 或 Java Dual-Pivot Quicksort)通常会结合以下优化:
-
三数取中法(Median-of-three):
不固定取第一个或最后一个元素,而是取首、尾、中三个位置上的中位数作为 Pivot,有效防止已排序数组导致的退化。
-
随机化 Pivot(Randomized Quick Sort):
随机选择一个元素作为 Pivot,从概率上消除恶意的极端测试用例攻击。
-
结合小数据量下的其他算法(内省排序 / IntroSort):
- 当递归分割到子数组长度很小(如 )时,直接切回插入排序(此时插入排序常数更小、速度更快)。
- 当递归深度过深(超过 )时,自动切换为堆排序,防止时间复杂度退化为 。
-
双路/三路划分(Three-way Partitioning):
处理有大量重复元素的数组时,将数组划分为“
< Pivot”、“== Pivot”、“> Pivot”三部分,大幅减少重复元素的无效比较与递归。