Prim 算法
Prim 是求解最小生成树的算法,从任意顶点出发维护一个已选顶点集合,每次选取连接集合内外、权值最小的边,将对应顶点并入集合,直到包含全部顶点;朴素实现 O(n^2) 适合稠密图,堆优化版本 O(mlog n) 适合稀疏图,支持负权边。
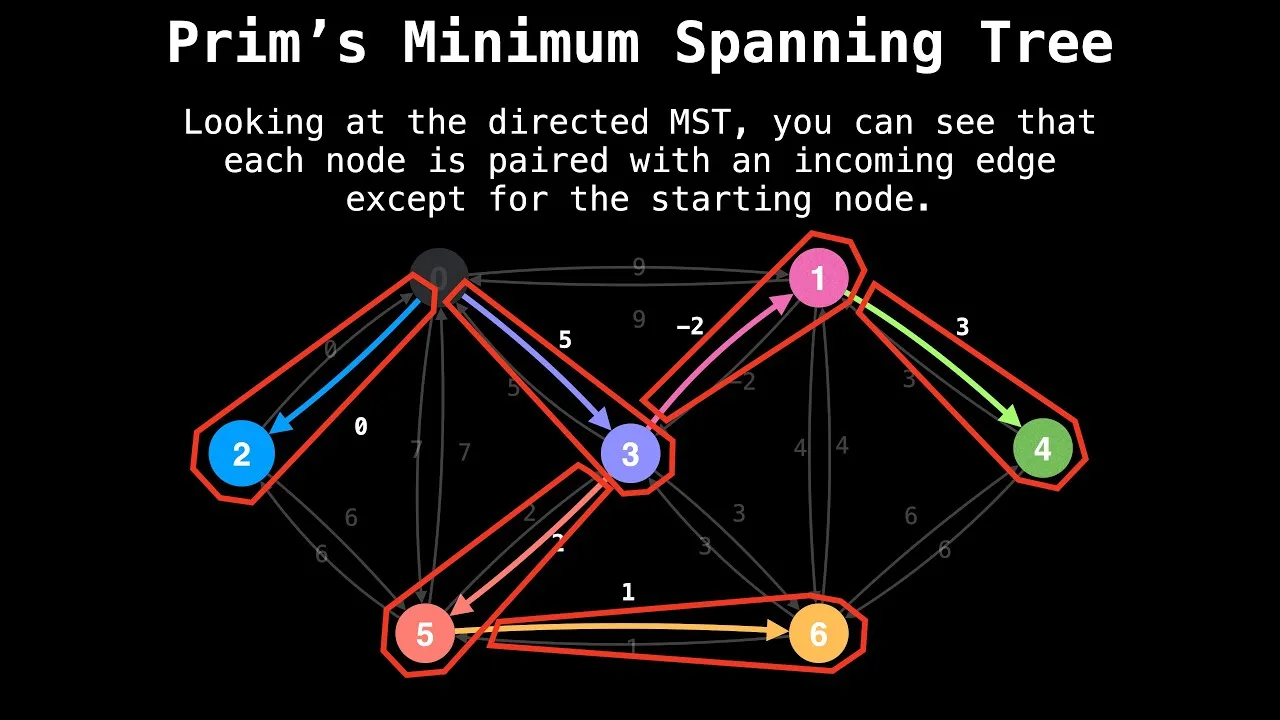
Prim 算法(普里姆算法)是求解最小生成树(MST)的另一种经典贪心算法,由捷克数学家 Vojtěch Jarník 于 1930 年首次提出,后由美国计算机科学家 Robert Prim 于 1957 年独立重新发现。
与 Kruskal 算法“按边全局排序加边”不同,Prim 算法的核心思想是 “加点法”(或称“生长法”):从某一个起始顶点开始,像一棵树一样向外“生长”,每次寻找已选顶点集合与未选顶点集合之间权值最小的边,将新顶点拉入树中,直到覆盖所有顶点。
假设图包含 个顶点和 条边:
-
集合划分:
维护两个顶点集合:
- :已经加入生成树的顶点集合(初始时仅包含一个指定的起点 )。
- :尚未加入生成树的顶点集合。
-
割边选择(割定理):
找到连接 与 的所有边中权值最小的一条边 ,其中 且 。
-
扩张更新:
- 将边 加入生成树。
- 将顶点 从 移入 。
- 更新新加入点 到剩余未选顶点的最小距离。
-
终止条件:当 包含了图中所有的顶点(即大小达到 )时,算法结束。
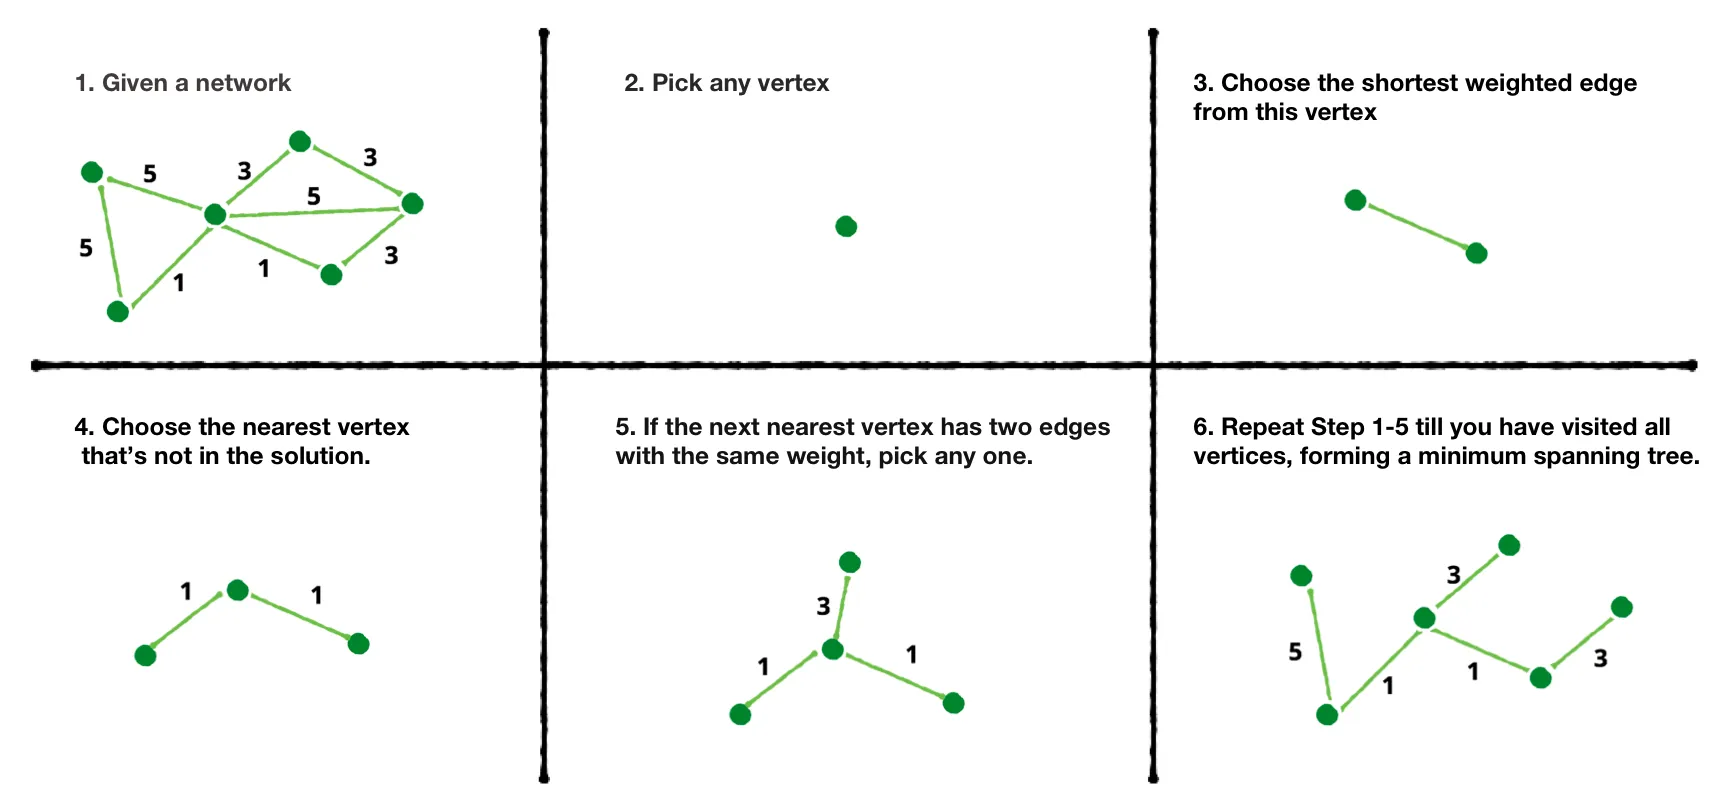
在朴素实现中,每次查找跨集合最小边需要遍历所有邻接点,时间复杂度为 。采用最小堆(优先队列)维护“割边”,可以将时间复杂度优化至 :
#include <iostream>#include <vector>#include <queue>
using namespace std;
// 邻接表节点结构:{目标顶点, 边权值}typedef pair<int, int> pii;
void prim(int n, const vector<vector<pii>>& adj, int start = 1) {    // 标记节点是否已加入树中 (即集合 S)    vector<bool> in_MST(n + 1, false);
    // 存储节点到已选集合 S 的最小距离,初始化为无穷大    vector<int> min_dist(n + 1, 1e9);
    // 优先队列存 {距离/权值, 顶点},小顶堆    priority_queue<pii, vector<pii>, greater<pii>> pq;
    int mst_weight = 0;    int nodes_added = 0;
    // 起点初始化    min_dist[start] = 0;    pq.push({0, start});
    while (!pq.empty() && nodes_added < n) {        auto [w, u] = pq.top();        pq.pop();
        // 如果节点 u 已经在 MST 中,忽略跳过        if (in_MST[u]) continue;
        // 将节点 u 纳入 MST 集合 S        in_MST[u] = true;        mst_weight += w;        nodes_added++;
        // 遍历 u 的所有邻接节点,更新它们到集合 S 的最短距离        for (const auto& edge : adj[u]) {            int v = edge.first;            int weight = edge.second;
            // 如果 v 不在 MST 中且通过 u 连接的权值更小            if (!in_MST[v] && weight < min_dist[v]) {                min_dist[v] = weight;                pq.push({min_dist[v], v});            }        }    }
if (nodes_added == n) { cout << "最小生成树总权值: " << mst_weight << endl; } else { cout << "图不连通,无法构成最小生成树!" << endl; }}根据实现方式的不同,Prim 算法的时间复杂度有明显差异:
| 实现方式 | 时间复杂度 | 适用场景 |
|---|---|---|
| 邻接矩阵 + 朴素查找 | 稠密图()最佳 | |
| 邻接表 + 二叉堆 (优先队列) | 稀疏图 / 通用场合 | |
| 邻接表 + 斐波那契堆 | 理论最优解 |
| 维度 | Prim 算法 | Kruskal 算法 |
|---|---|---|
| 增长模式 | 维护单棵树,逐步扩张加入点 | 维护森林,逐步合并连通分量 |
| 关键操作 | 查找集合边界上的最小边 | 边权全局排序 + 并查集判环 |
| 空间复杂度 | (存储图和队列) | (存储边和并查集) |
| 最适用图结构 | 稠密图(边较多时效率高) | 稀疏图(边较少时效率高) |