Kruskal 算法
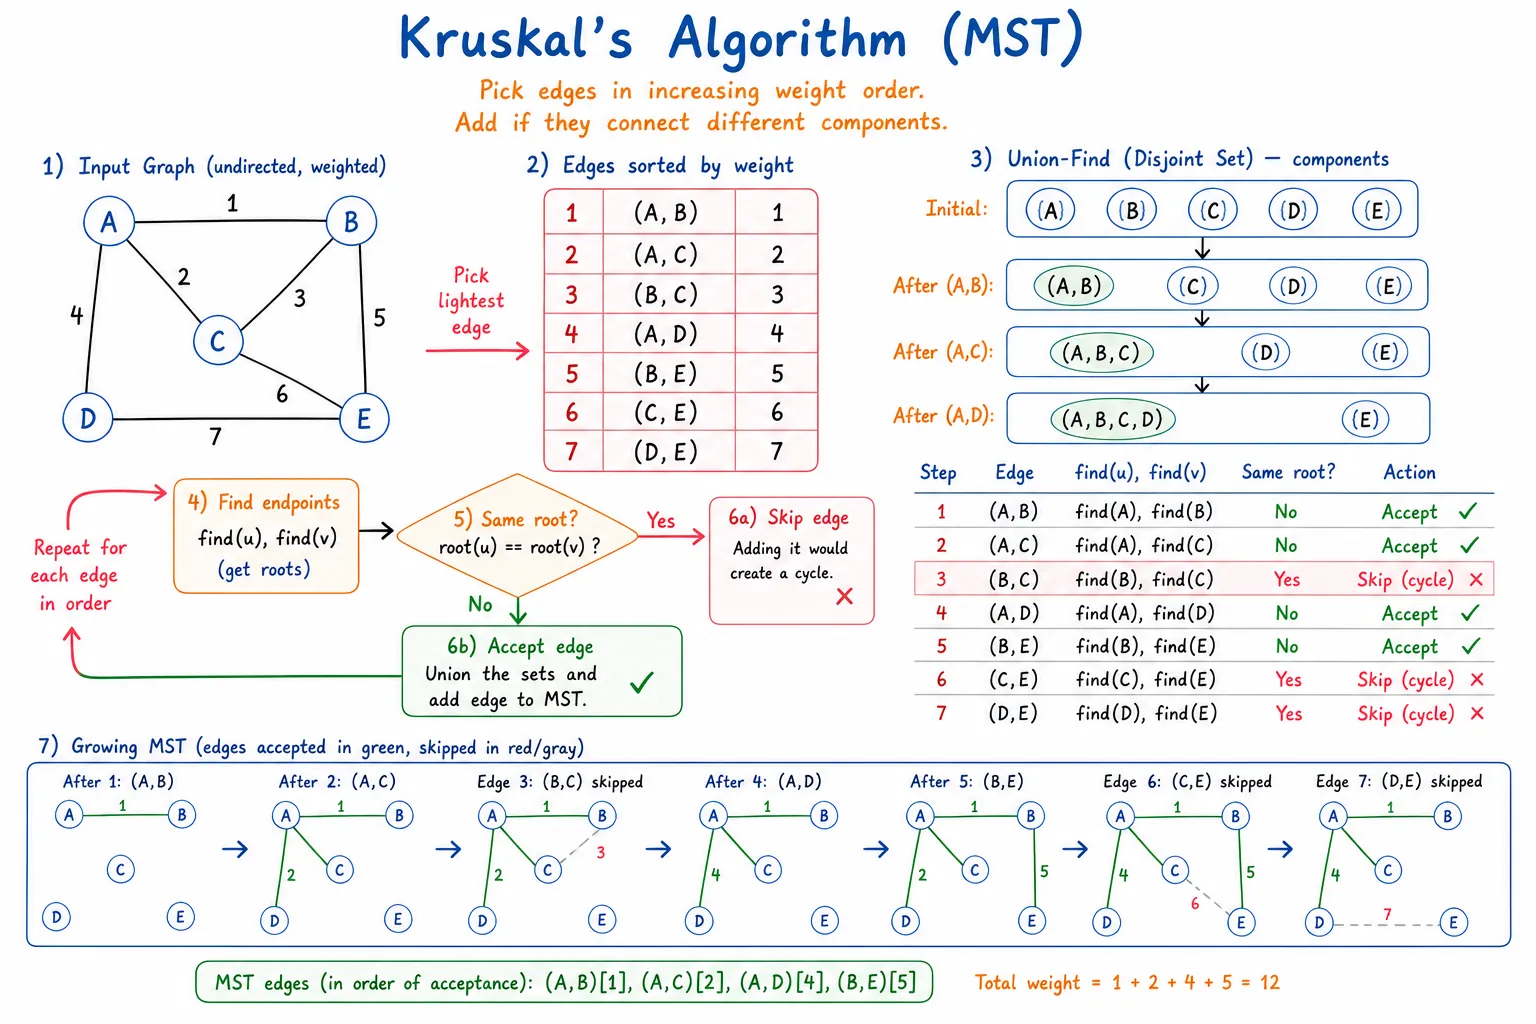
Kruskal 是求解最小生成树的算法,核心思路是将全部边按权值从小到大排序,依次选取边,借助并查集判断边的两个端点是否属于不同连通块,若不连通就把这条边加入生成树,直到选出 n‑1 条边;适合稀疏图,时间复杂度主要由排序决定 O(mlog m),可以处理带负权的边。
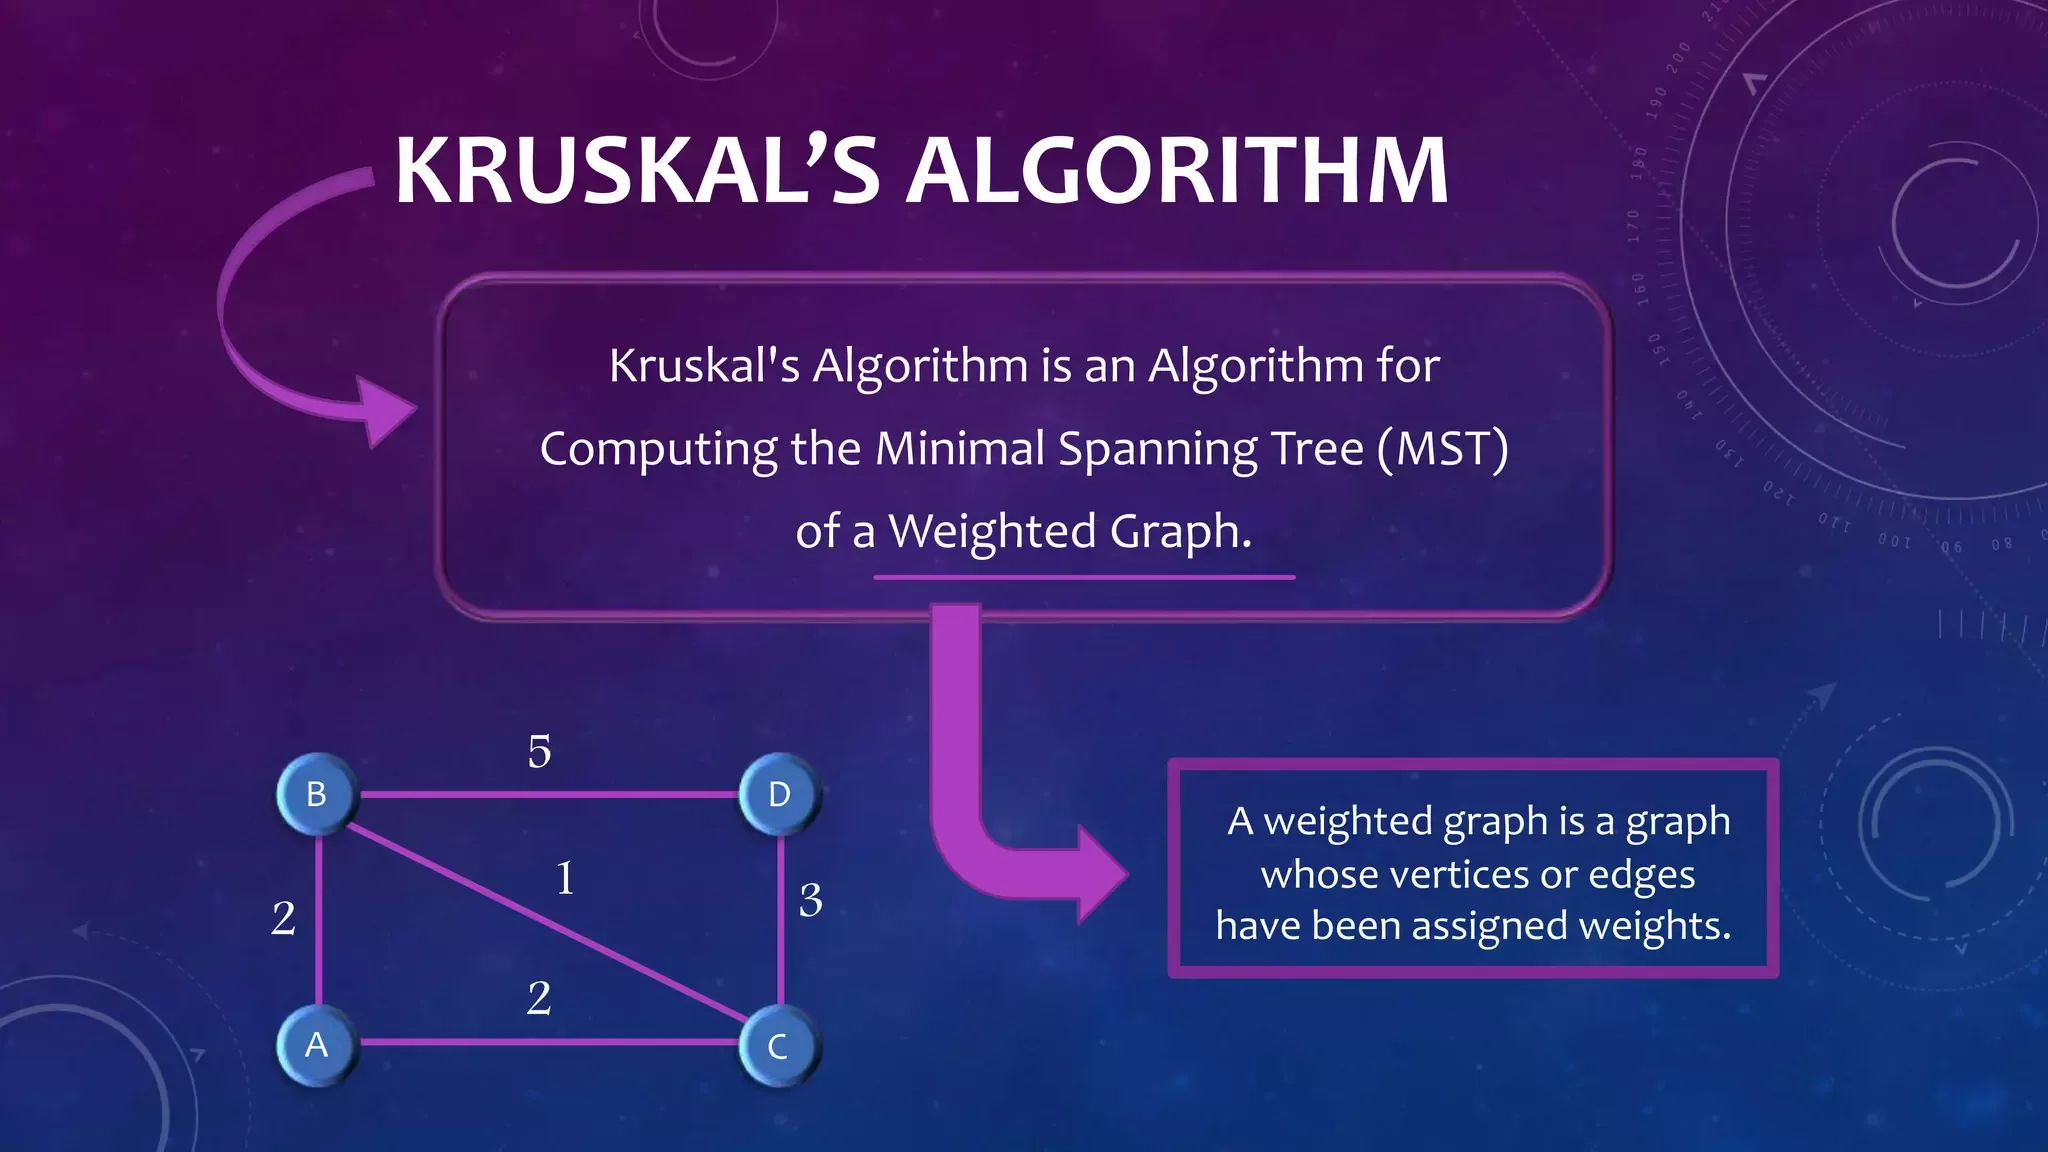
Kruskal 算法(克鲁斯卡尔算法)是求解最小生成树(MST)最直观、最常用的贪心算法之一,由 Joseph Kruskal 于 1956 年提出。
其核心思想非常朴素:“加边法” —— 每次都选择当前权值最小的边,只要这条边不会与已选的边构成环,就把它加入到生成树中,直到连接了图中所有的顶点。
假设图包含 个顶点和 条边:
- 结构准备:将图中的每一个顶点看作一个独立的连通分量(即包含 棵树的森林)。
- 边权排序:将图中的所有 条边按照权值从小到大进行升序排序。
- 贪心选边:按排序顺序依次检查每条边 :
- 如果顶点 和顶点 不在同一个连通分量中(即加入该边不会形成环),则选中这条边,并将 与 所在的连通分量合并。
- 如果顶点 和顶点 已经在同一个连通分量中,则舍弃这条边(避免产生环)。
- 终止条件:当选中的边数达到 条时,算法结束。此时选出的边即构成最小生成树。
Kruskal 算法能否高效运行,关键在于如何快速判断两个顶点是否属于同一个连通分量以及如何合并两个连通分量。这需要借助并查集数据结构:
- 查找(Find):查询顶点 所在的根节点,判断两点是否相连(若
find(u) == find(v),说明两点连通,加入该边会成环)。 - 合并(Union):将两个顶点所在的集合合并为一个集合。
- 优化策略:配合路径压缩(Path Compression)和按秩合并(Union by Rank),并查集的单次操作近乎 时间。
以下是基于并查集优化的完整 C++ 实现:
#include <iostream>#include <vector>#include <algorithm>
using namespace std;
// 边的结构体struct Edge {    int u, v, weight;    // 按权值升序排序    bool operator<(const Edge& other) const {        return weight < other.weight;    }};
// 并查集结构struct DSU {    vector<int> parent;    DSU(int n) {        parent.resize(n + 1);        for (int i = 1; i <= n; ++i) parent[i] = i;    }    // 带路径压缩的查找    int find(int i) {        if (parent[i] == i)            return i;        return parent[i] = find(parent[i]);    }    // 合并操作    bool unite(int i, int j) {        int root_i = find(i);        int root_j = find(j);        if (root_i != root_j) {            parent[root_i] = root_j;            return true; // 合并成功        }        return false; // 已在同一集合中,会形成环    }};
void kruskal(int n, vector<Edge>& edges) {    // 1. 按边权升序排序    sort(edges.begin(), edges.end());
    DSU dsu(n);    int mst_weight = 0;    int edges_count = 0;    vector<Edge> mst_edges;
    // 2. 依次遍历每条边    for (const auto& edge : edges) {        if (dsu.unite(edge.u, edge.v)) {            mst_weight += edge.weight;            mst_edges.push_back(edge);            edges_count++;
            // 选满 n-1 条边提前退出            if (edges_count == n - 1) break;        }    }
// 3. 输出结果 if (edges_count == n - 1) { cout << "最小生成树总权值: " << mst_weight << endl; cout << "选取的边如下:" << endl; for (const auto& e : mst_edges) { cout << e.u << " -- " << e.v << " (权值: " << e.weight << ")" << endl; } } else { cout << "图不连通,无法构成最小生成树!" << endl; }}- 时间复杂度:
- 边排序:对 条边进行排序需要 。
- 并查集操作:遍历所有边进行查找与合并,采用路径压缩后总时间为 (其中 为阿克曼函数的反函数,可视为常数)。
- 整体时间复杂度: 或 (因为 ,)。
- 空间复杂度:,主要用于存储所有边和并查集的父节点数组。
- 优点:逻辑简单直观,代码易于实现;对于稀疏图()性能非常出色。
- 缺点:对于稠密图(边数极多),对大量边进行排序会占用较多时间和空间,此时 Prim 算法通常表现更好。