链表
链表是一种线性数据结构,它的每个节点存储数据与指向下一节点的指针,节点在内存中不必连续存放;不支持随机访问,查找需要从头依次遍历,但插入、删除元素时只需修改指针,不用移动大量数据,适合频繁增删的场景。
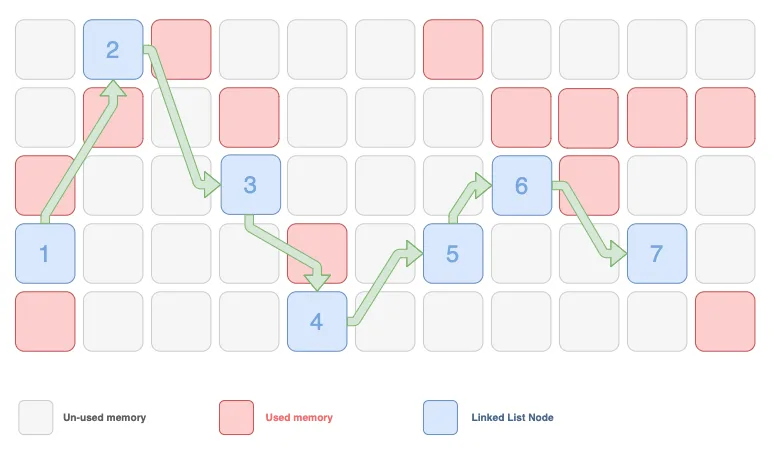
链表(Linked List)是继数组之后最常用的动态线性数据结构。就像按顺序首尾相接的火车车厢一样,链表由一系列存储在内存不连续位置的“节点”链接而成,每个节点都包含存放具体内容的数据域和指向下一个节点的指针域。
链表的设计初衷是为了解决数组的天然弱点:数组插入和删除元素时需要平移大量数据,且内存大小固定;而链表基于动态内存分配,在已知目标节点位置的前提下,插入和删除操作均可在 的恒定时间复杂度内完成。不过,这种非连续存储也带来了权衡——链表无法像数组那样通过下标直接进行随机访问,所有的元素查找都必须按顺序依次进行。
- 节点 (Node): 链表的基本组成单元,封装了数据和指向其他节点的引用/指针。
- 数据域 (Data / Payload): 节点中专门用于存放实际业务数据(如整数、字符串或结构体)的区域。
- 指针域 (Next / Prev): 节点中用于存放指向下一个(
next)或上一个(prev)节点内存地址的引用变量。 - 前驱节点 (Predecessor) 与 后继节点 (Successor): 相邻节点中,位于当前节点紧邻前方的称为“前驱”,紧邻后方的称为“后继”。
- 头指针 / 头节点 (Head): 链表的入口指针,保存首个节点的内存地址,是访问整条链表的唯一入口。
- 尾节点 (Tail): 链表中的最后一个节点,在普通链表中,其
next指针通常指向空值。 - 哨兵节点 / 哑节点 (Sentinel Node / Dummy Head): 放置在链表头部(或尾部)的“虚拟节点”,不存放真实业务数据。引入它的目的是简化代码逻辑,避免每次插入/删除时都要判断头指针是否为
NULL。 - 空指针 (NULL / nullptr / None): 表示不指向任何有效内存地址的指针,常用作非循环链表的终止标记。
在实际工程中,为了应对不同的业务需求,链表由最基础的单向链表演进出了双向链表与循环链表。
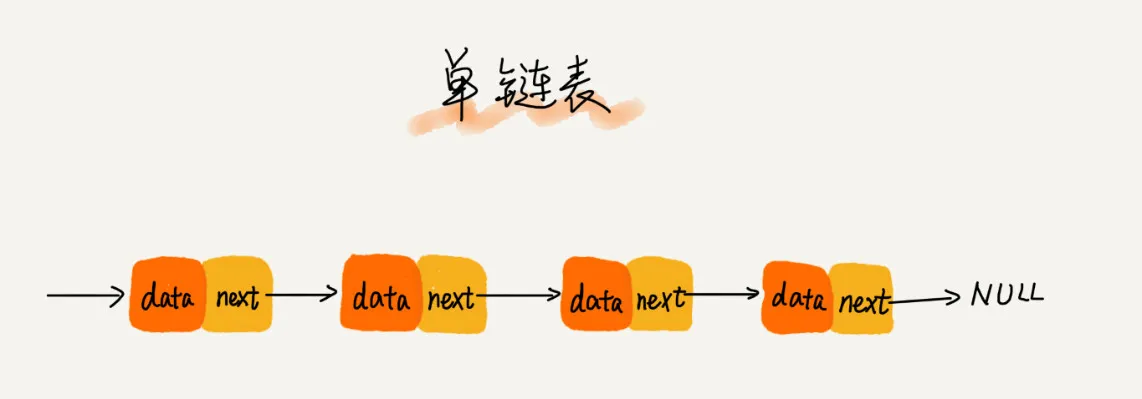
单向链表(Singly Linked List) 是最基础的链表结构。每个节点仅包含一个指向后继节点的 next 指针,只能单向向前遍历。
#include <stdio.h>#include <stdlib.h>
// 单向链表节点定义typedef struct SinglyNode {    int data;                 // 数据域:存放节点数据    struct SinglyNode* next;  // 指针域:指向下一个节点} SinglyNode;
// 创建新节点(辅助函数)SinglyNode* createSinglyNode(int value) { SinglyNode* newNode = (SinglyNode*)malloc(sizeof(SinglyNode)); if (newNode == NULL) { printf("内存分配失败!\n"); return NULL; } newNode->data = value; newNode->next = NULL; return newNode;}插入的核心在于将新节点的指针与前后节点重新搭桥连接。常见场景包括头插法、尾插法以及指定位置插入:
- 头插法 / 尾插法逻辑: 头插只需让新节点指向原头节点并更新头指针,复杂度为 ;尾插需遍历至尾节点(
next == NULL),复杂度为 。 - 指定位置插入逻辑(按索引/位置):
- 若插入位置 ,直接调用头插逻辑。
- 否则,从头遍历 步,找到目标位置的前驱节点
prev。 - 若还没走到指定位置
prev就已为空,说明越界;若未越界,则先将新节点的next指向prev->next,再将prev->next指向新节点。
// 头插法void insertSinglyHead(SinglyNode** head, int value) {    SinglyNode* newNode = createSinglyNode(value);    if (newNode == NULL) return;    newNode->next = *head;    *head = newNode;}
// 尾插法void insertSinglyTail(SinglyNode** head, int value) {    SinglyNode* newNode = createSinglyNode(value);    if (newNode == NULL) return;
    if (*head == NULL) {        *head = newNode;        return;    }    SinglyNode* temp = *head;    while (temp->next != NULL) {        temp = temp->next;    }    temp->next = newNode;}
// 在指定位置 pos 插入节点 (pos 从 1 开始计算)bool insertSinglyAt(SinglyNode** head, int pos, int value) {    if (pos < 1) return false; // 位置合法性校验
    if (pos == 1) { // 插入到头部        insertSinglyHead(head, value);        return true;    }
    SinglyNode* temp = *head;    // 寻找第 pos - 1 个节点(前驱节点)    for (int i = 1; temp != NULL && i < pos - 1; i++) {        temp = temp->next;    }
    if (temp == NULL) return false; // pos 超过链表长度 + 1(越界)
    SinglyNode* newNode = createSinglyNode(value);    if (newNode == NULL) return false;
newNode->next = temp->next; // 先接后路 temp->next = newNode; // 再断前路并重连 return true;}删除的核心在于跳过目标节点更新指针连接(断链),并手动释放被删除节点的内存空间:
- 按值删除逻辑: 寻找数据匹配的节点,记录其前驱节点
prev和目标节点temp,通过prev->next = temp->next绕过目标节点后释放内存。 - 指定位置删除逻辑(按索引/位置):
- 若链表为空或位置小于 1,返回失败。
- 若删除位置 ,将头指针指向下一个节点
*head = (*head)->next并释放原头节点。 - 否则,从头遍历 步找到待删除节点的前驱
prev。 - 若
prev或其后继节点prev->next(即待删除节点)为空,说明越界;若未越界,让prev->next指向待删节点的后继,最后free目标节点。
// 按值删除首个匹配节点void deleteSinglyNode(SinglyNode** head, int value) {    if (*head == NULL) return;
    SinglyNode* temp = *head;    SinglyNode* prev = NULL;
    if (temp->data == value) { // 头节点匹配        *head = temp->next;        free(temp);        return;    }
    while (temp != NULL && temp->data != value) {        prev = temp;        temp = temp->next;    }
    if (temp == NULL) return; // 未找到
    prev->next = temp->next;    free(temp);}
// 在指定位置 pos 删除节点 (pos 从 1 开始计算)bool deleteSinglyAt(SinglyNode** head, int pos) {    if (*head == NULL || pos < 1) return false; // 空链表或位置非法
    if (pos == 1) { // 删除头节点        SinglyNode* temp = *head;        *head = (*head)->next;        free(temp);        return true;    }
    SinglyNode* temp = *head;    // 寻找第 pos - 1 个节点(前驱节点)    for (int i = 1; temp != NULL && i < pos - 1; i++) {        temp = temp->next;    }
    // temp 为空说明 pos 超出范围;temp->next 为空说明没有第 pos 个节点    if (temp == NULL || temp->next == NULL) return false;
    SinglyNode* target = temp->next; // 目标删除节点    temp->next = target->next;       // 重新搭桥绕过目标节点    free(target);                    // 释放内存    return true;}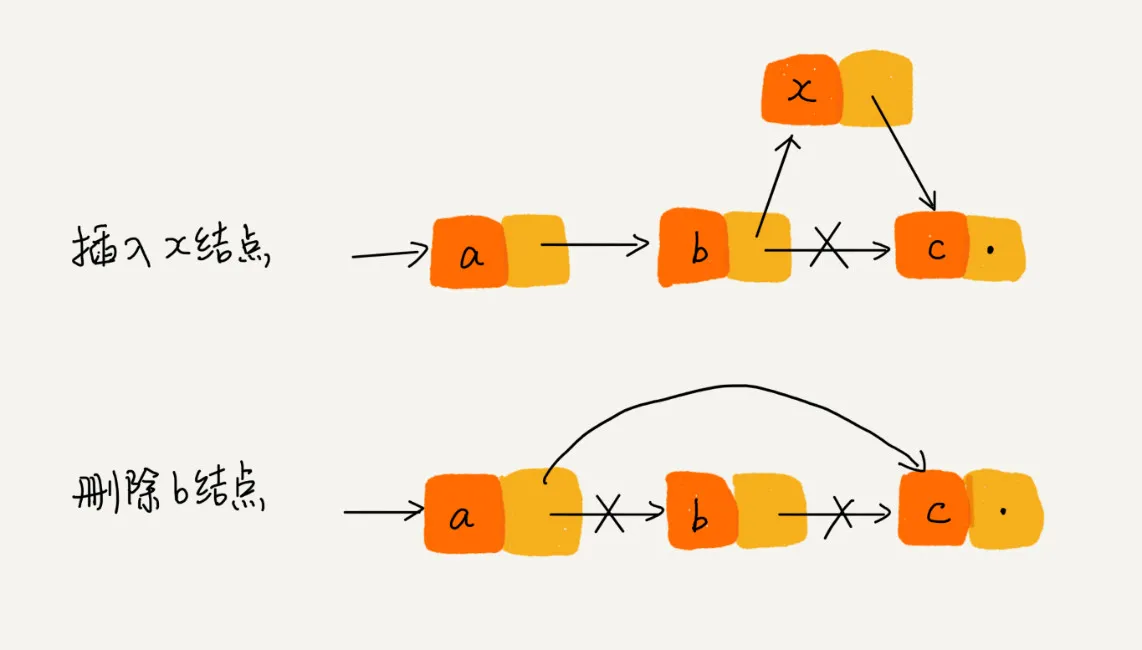
尽管单向链表结构简单且节省内存,但它在许多工程场景中存在明显缺陷:
- 无法逆向遍历: 指针只能单向向前(
next)。如果需要倒序查找或实现类似浏览器的“后退”、编辑器的“撤销”功能,单向链表无法直接满足需求。 - 删除/插入已知节点效率低: 给定一个已知节点
p,若要将其删除,由于无法直接获取其前驱节点(prev),必须从头节点head开始重新遍历寻找p的前驱,导致删除操作从预期中的 退化为 。
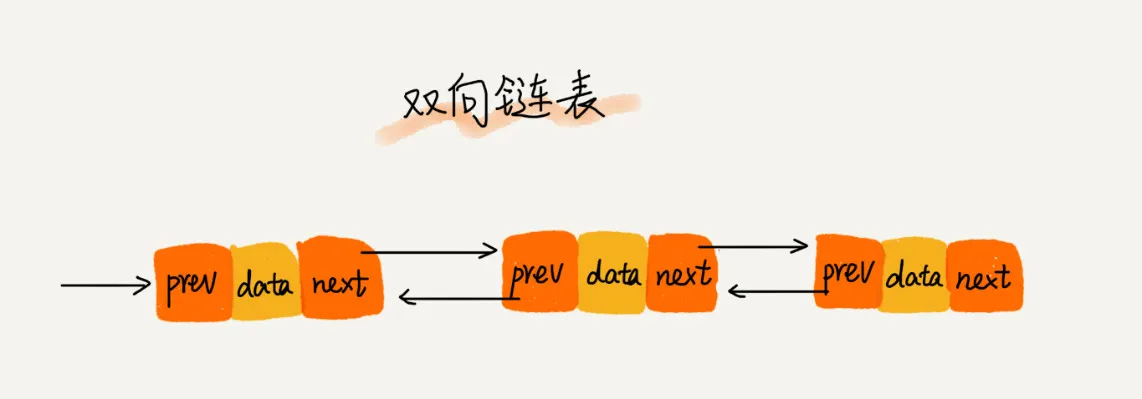
为了克服单向链表“无法反向遍历”和“获取前驱节点成本高”的问题,双向链表(Doubly Linked List) 应运而生。它的每个节点同时包含指向前驱节点的 prev 指针和指向后继节点的 next 指针。
typedef struct DoublyNode { int data; struct DoublyNode* prev; // 指向前驱节点 struct DoublyNode* next; // 指向后继节点} DoublyNode;// 创建双向节点DoublyNode* createDoublyNode(int value) { DoublyNode* newNode = (DoublyNode*)malloc(sizeof(DoublyNode)); newNode->data = value; newNode->prev = NULL; newNode->next = NULL; return newNode;}
// 尾部插入void insertDoublyTail(DoublyNode** head, int value) { DoublyNode* newNode = createDoublyNode(value); if (*head == NULL) { *head = newNode; return; } DoublyNode* temp = *head; while (temp->next != NULL) { temp = temp->next; } temp->next = newNode; newNode->prev = temp; // 建立反向指针}
// 删除指定节点 p (无需遍历寻前驱,时间复杂度 O(1))void deleteDoublyNode(DoublyNode** head, DoublyNode* p) { if (*head == NULL || p == NULL) return;
if (*head == p) *head = p->next; if (p->next != NULL) p->next->prev = p->prev; if (p->prev != NULL) p->prev->next = p->next;
free(p);}双向链表虽然解决了前后遍历的问题,但它本质上依然是“有头有尾”的线性结构,尾节点依然止于 NULL。这导致遍历到尽头后无法直接绕回起点,在面对 CPU 时间片轮询、循环播放列表这类天然需要首尾贯通的场景时,处理边界逻辑依然很不方便。
为了打破“链表必须有终点”的局限,循环链表(Circular Linked List) 将尾节点的 next 重新指向头节点 head,从而构建出一个首尾相连的闭环结构。单向和双向链表均可构建为循环链表(以下以单向循环链表为例)。
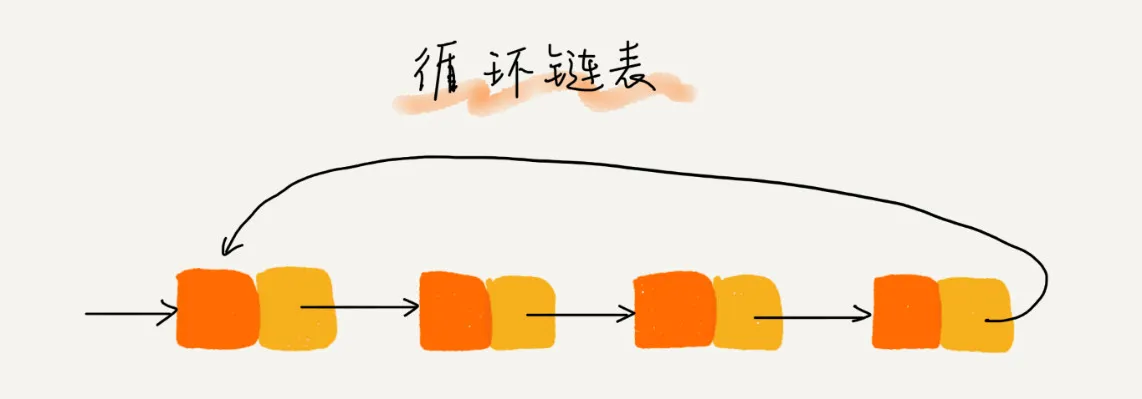
// 循环链表节点定义(结构与单向链表一致)typedef struct CircularNode { int data; struct CircularNode* next;} CircularNode;// 创建循环链表节点CircularNode* createCircularNode(int value) { CircularNode* newNode = (CircularNode*)malloc(sizeof(CircularNode)); newNode->data = value; newNode->next = NULL; return newNode;}
// 尾部插入void insertCircularTail(CircularNode** head, int value) { CircularNode* newNode = createCircularNode(value); if (*head == NULL) { *head = newNode; newNode->next = *head; // 自己指向自己,构成首尾相连 return; } CircularNode* temp = *head; while (temp->next != *head) { // 寻找最后一个节点 temp = temp->next; } temp->next = newNode; newNode->next = *head; // 重新指向头节点}| 对比维度 | 单向链表 | 双向链表 | 循环链表 |
|---|---|---|---|
| 指针占用 | 1 个指针 (next) | 2 个指针 (prev, next) | 1 个或 2 个指针 |
| 遍历方向 | 仅支持单向向前 | 支持双向正反遍历 | 可从任意节点出发循环遍历全局 |
| 删除操作复杂度 | 需要 查找前驱 | 直接通过 prev 获取前驱, | 单向循环需 ,双向循环需 |
| 边界条件判断 | node->next == NULL | node->next == NULL | node->next == head |
| 主要优点 | 结构最简单,节省指针内存 | 操作最方便,支持反向查找与高效删除 | 适合无头无尾的环形业务场景 |
| 常见应用场景 | 基础 Stack/Queue、图的邻接表 | 浏览器前进/后退、LRU 缓存算法、文本撤销 | 约瑟夫环、操作系统 CPU 时间片轮询调度 |
数据结构中没有绝对的优劣,只有是否契合具体的应用场景:
| 操作 / 特性 | 链表 | 数组 | 原理分析 |
|---|---|---|---|
| 随机访问 | 较慢: | 极快: | 链表非连续存储,必须从头遍历;数组连续存储,可由下标直接计算内存偏移量。 |
| 头部/中间插入与删除 | 极快:* | 较慢: | 链表只需修改关联节点的指针;数组在插入/删除时需要整体平移后续所有元素。 |
| 内存扩容与分配 | 动态按需分配 | 需预先指定或翻倍扩容 | 链表随用随申请内存;动态数组扩容时需重新申请大块内存并执行全量拷贝。 |
| 空间利用效率与开销 | 附加开销大 | 紧凑高效 | 链表每个节点都需要额外的指针空间(如 64 位系统下每个指针占用 8 字节)。 |
| 缓存局部性 (Cache Line) | 较差 | 极佳 | 数组连续分布对 CPU 高速缓存友好;链表节点离散分布,易触发 Cache Miss。 |
注意: 链表在已知目标节点位置时的插入和删除操作复杂度为 ;但如果需要先从头查找到指定位置,查找过程依然需要 的时间。