哈希表
哈希表是一种通过哈希函数把键映射到数组下标,从而实现平均 O (1) 时间复杂度查找、插入和删除的数据结构。
数据结构1分钟阅读
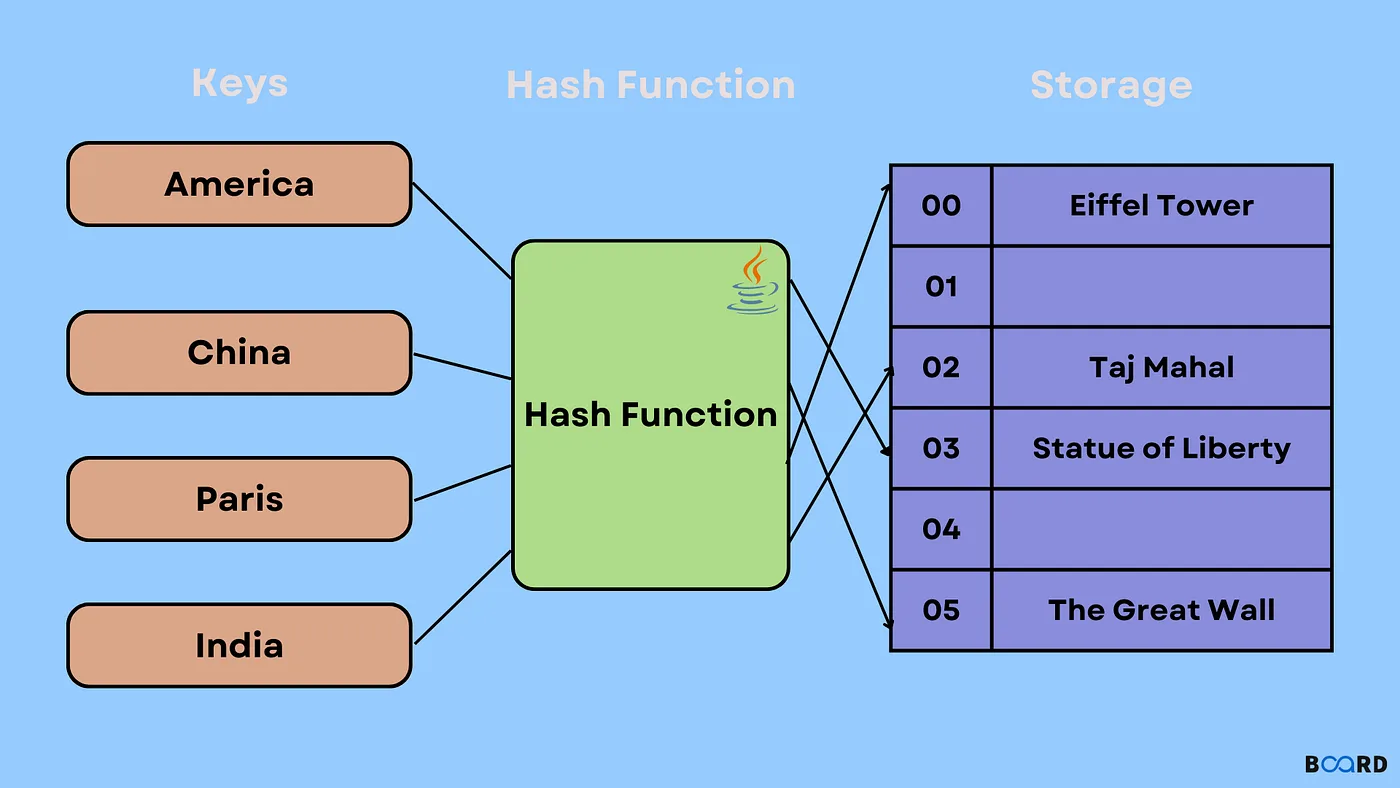
哈希表(Hash Table),也叫散列表,是计算机科学中最核心的数据结构之一。如果把数组比作“按编号找人”,那哈希表就是“按名字直接找人”。
它的核心优势在于:极快。在理想情况下,插入、查找和删除的时间复杂度都是 (即常数时间,无论数据量多大,几乎瞬间完成)。
哈希表的核心秘密在于:利用映射函数把复杂的查找转变为直接的数组下标访问。
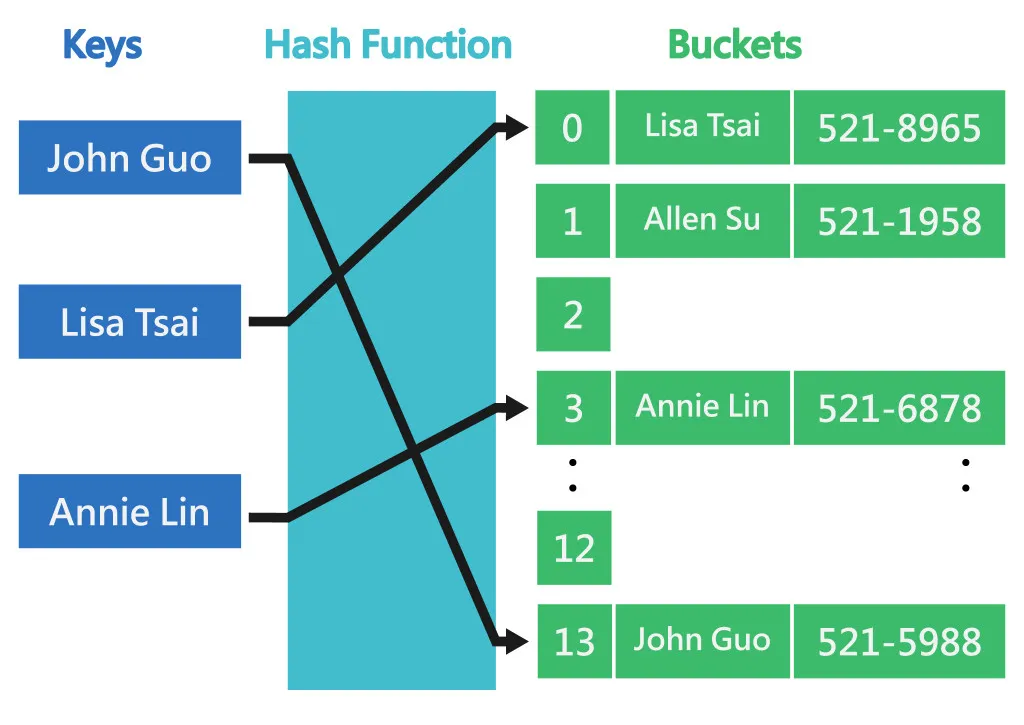
它主要由两部分组成:
- 键值对(Key-Value Pair): 你存入的数据。比如用
Key存用户名,用Value存用户的详细资料。 - 哈希函数(Hash Function): 一个数学公式。你给它一个
Key(比如字符串"apple"),它会计算出一个整数数字(比如3)。这个数字就是底层数组的下标(Index)。
理想很美好,但数组大小是有限的,而 Key 的组合是无限的。如果不同的 Key 计算出了相同的下标,就会发生哈希冲突(比如 "apple" 和 "banana" 算出来的索引都是 3)。
解决冲突主要有两种最经典的策略:
- 原理: 数组的每个位置不直接存数据,而是挂一个链表(或者红黑树)。
- 处理过程: 冲突发生时,把新的键值对直接挂在对应位置的链表末尾。
- 代表语言: Java 中的
HashMap、C++ 中的std::unordered_map。
- 原理: 如果算出来的坑位已经被占了,就按照某种规则往后找下一个空的坑位。
- 探查方式: 比如线性探测(挨个看下一个坑)、二次探测或双重哈希。
- 代表语言: Python 中的
dict。
- 普通数组: 按索引查 ,按值查 (要挨个找)。
- 链表: 查任何元素都是 。
- 平衡二叉树: 查找需要 。
- 哈希表: 借助哈希函数,一步到位算出存储地址,直接定位,因此是 。
什么时候会变慢?
当装载因子(Load Factor = 已存元素数 / 数组容量)过高,或者哈希函数设计得很糟糕导致大量冲突时,哈希表会退化成链表,查找效率会降为 。因此,哈希表会在空间不够时自动触发扩容(Rehash)。
虽然底层原理一致,但在不同语言里它的名字不太一样:
| 语言 | 对应实现/名称 |
|---|---|
| C++ | std::unordered_map |
| Java | HashMap |
| Python | dict(字典) |
| JavaScript | Object / Map |
| Go | map |
- ⚡ 极速读写: 插入、删除、查询在平均情况下均为 。
- 🔑 灵活的 Key: 可以用字符串、对象等任意能计算哈希值的类型作为索引。
- ❌ 无序性: 传统的哈希表内部元素是无序存放的(Python 3.7+ 的 dict 通过附加索引数组实现了按插入顺序排列,但底层依然不按 Key 排序)。
- ❌ 范围查询极慢: 无法高效地进行“查找大于 10 且小于 50 的所有元素”这种操作(这种场景通常用 B+ 树 或 红黑树)。
- ❌ 内存开销较多: 需要预留额外的数组空间来降低冲突概率。