归并排序
归并排序采用分治思想,先把数组不断对半拆分成子数组,对子数组排序后,再将两个有序子数组合并为一个有序数组;时间复杂度稳定为 O (nlogn),需要额外辅助空间,是稳定排序算法。
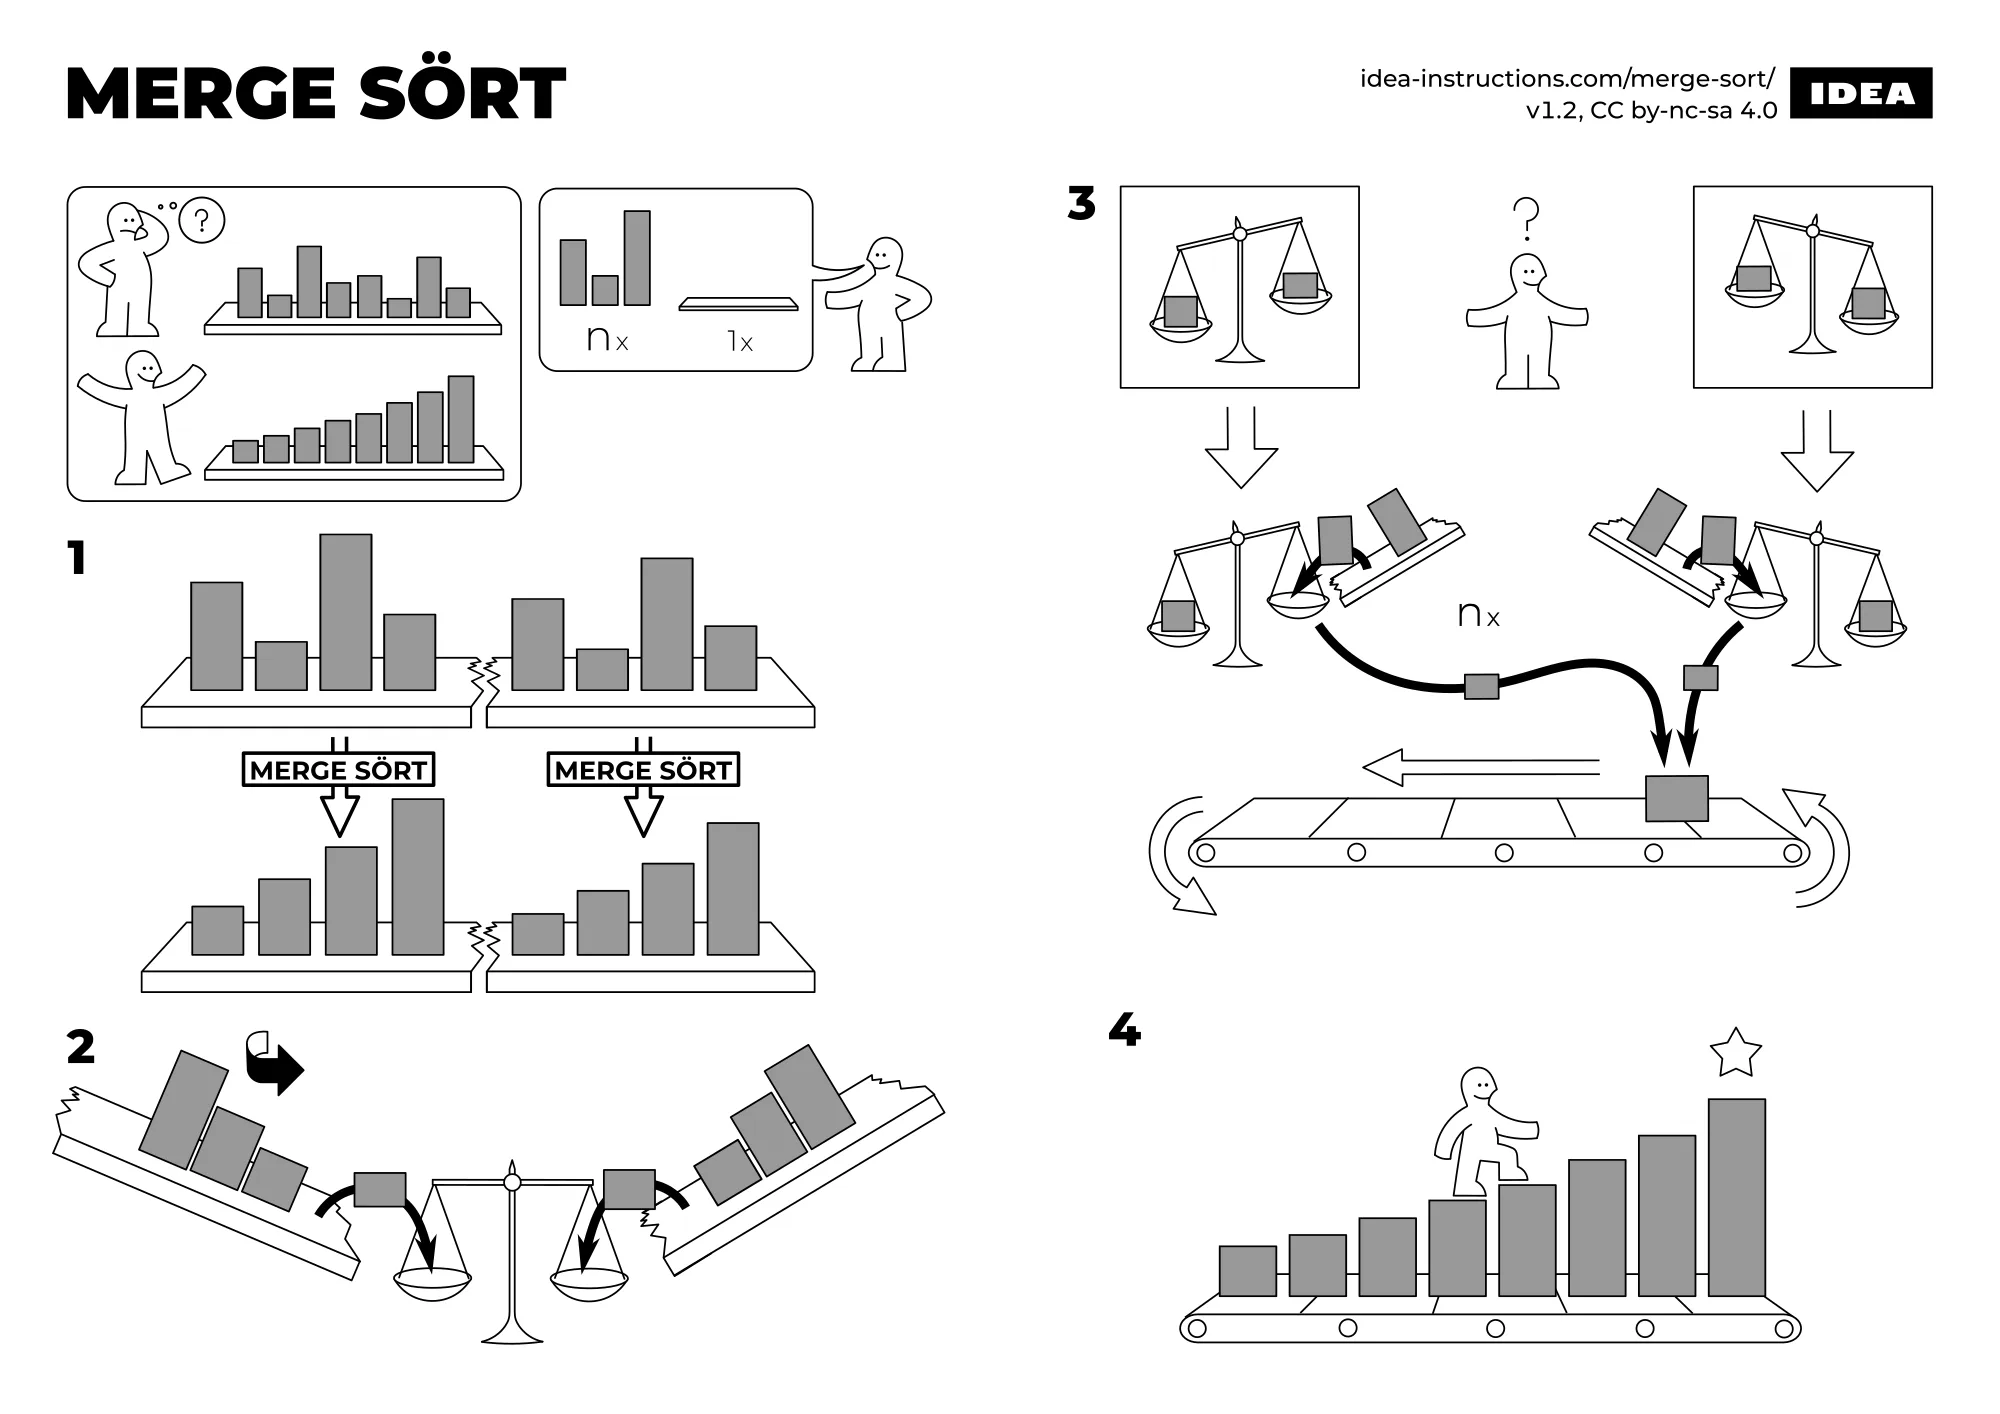
归并排序(Merge Sort)是一种基于 分治法(Divide and Conquer) 的高效、稳定的经典排序算法。它的核心思想是:将一个大问题拆分成若干个小问题,解决小问题后,再将小问题的解合并起来得到大问题的解。
归并排序主要分为三个步骤:
- 分(Divide): 找到当前数组的中点,将数组从中间切开,一分为二,分成左右两个子数组。
- 治(Conquer): 递归地对左右两个子数组分别进行归并排序。当子数组的长度为 1 时,递归到达基线条件(单元素数组天然有序)。
- 合(Combine): 将两个已经排好序的子数组合并成一个整体有序的大数组。
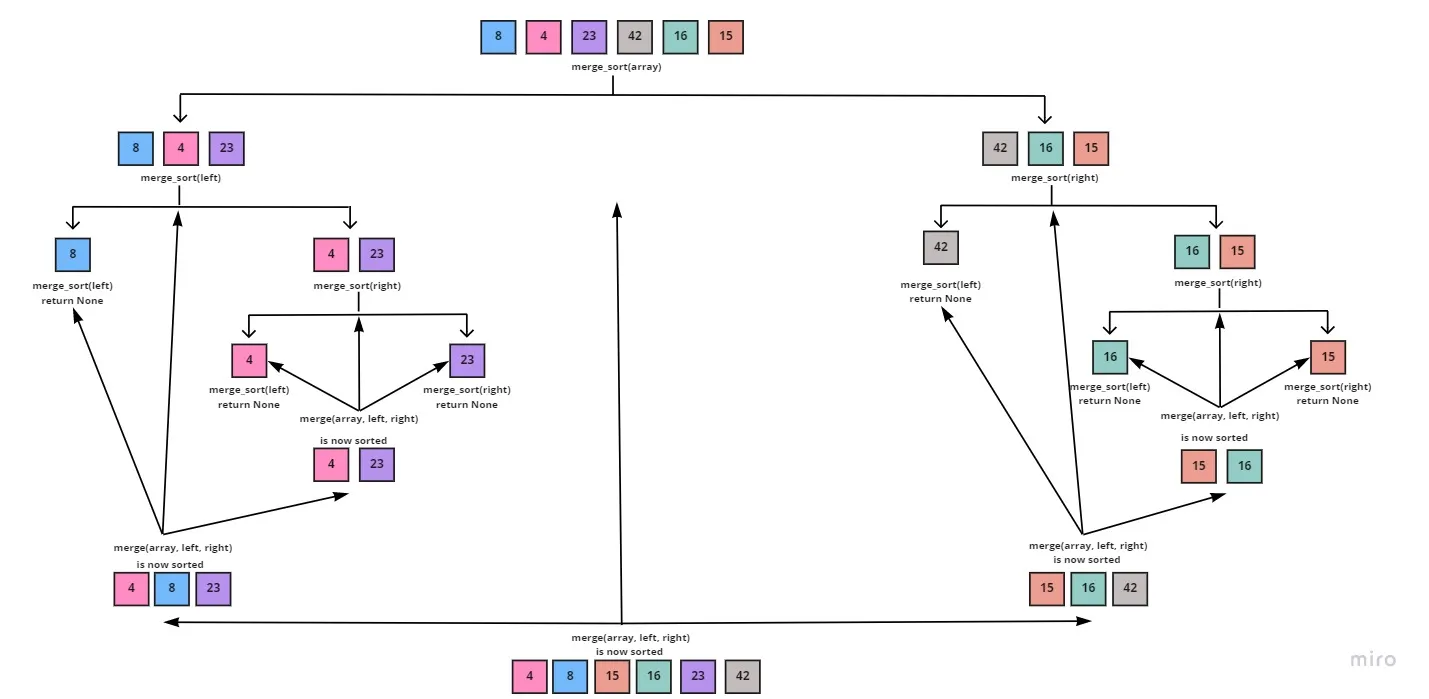
merge_sort 递归把数组不断对半拆分为子数组,直到单个元素;再通过 merge 函数自底向上把有序子数组合并,最终得到有序数组 [4,8,15,16,23,42]。归并排序最常用的方式是自顶向下的递归实现。为了保证性能,我们通常会传入一个辅助数组 temp 来避免反复在递归中创建和销毁内存。
#include <iostream>#include <vector>
// 合并两个有序子数组:arr[left..mid] 和 arr[mid+1..right]void merge(std::vector<int>& arr, int left, int mid, int right, std::vector<int>& temp) {    int i = left;      // 左子数组的起点    int j = mid + 1;  // 右子数组的起点    int k = left;      // 辅助数组 temp 的写入索引
    // 比较两个子数组的元素,将较小者依次放入 temp 中    while (i <= mid && j <= right) {        if (arr[i] <= arr[j]) { // <= 保证了算法的稳定性            temp[k++] = arr[i++];        } else {            temp[k++] = arr[j++];        }    }
    // 处理左子数组可能剩余的元素    while (i <= mid) {        temp[k++] = arr[i++];    }
    // 处理右子数组可能剩余的元素    while (j <= right) {        temp[k++] = arr[j++];    }
    // 将合并后的结果从 temp 拷贝回原数组 arr    for (int p = left; p <= right; ++p) {        arr[p] = temp[p];    }}
// 归并排序主递归函数void mergeSortRecursive(std::vector<int>& arr, int left, int right, std::vector<int>& temp) {    // 递归基线条件:子数组长度小于等于 1    if (left >= right) {        return;    }
    // 计算中点,防止 (left + right) 溢出    int mid = left + (right - left) / 2;
    // 递归对左右两半部分排序    mergeSortRecursive(arr, left, mid, temp);    mergeSortRecursive(arr, mid + 1, right, temp);
    // 将排序好的两部分合并    merge(arr, left, mid, right, temp);}
// 对外暴露的接口void mergeSort(std::vector<int>& arr) {    if (arr.empty()) return;    std::vector<int> temp(arr.size());    mergeSortRecursive(arr, 0, arr.size() - 1, temp);}
int main() {    std::vector<int> nums = {38, 27, 43, 3, 9, 82, 10};
    std::cout << "排序前: ";    for (int num : nums) std::cout << num << " ";    std::cout << std::endl;
    mergeSort(nums);
    std::cout << "排序后: ";    for (int num : nums) std::cout << num << " ";    std::cout << std::endl;
return 0;}| 评价维度 | 复杂度/特性 | 详细说明 |
|---|---|---|
| 最好时间复杂度 | 无论初始序列是否有序,二分拆分的深度均为 ,每层合并需要 时间。 | |
| 最坏时间复杂度 | 性能非常稳定,不会像快速排序那样在极极端情况下退化成 。 | |
| 平均时间复杂度 | 综合表现恒定。 | |
| 空间复杂度 | 需要一个与原数组等长的辅助数组来临时存放合并后的数据;另外递归栈消耗 空间。 | |
| 稳定性 | 稳定 | 在合并两段数组时,遇到相同值的元素,若优先拷贝左段数组的元素,就能保证相同元素的相对顺序不改变。 |
- 非常稳定且高性能: 无论数据情况如何,最坏情况时间复杂度依然保证在 。
- 稳定排序: 对于包含键值对或包含相同属性对象的排序需求非常友善。
- 适合链表排序: 链表不支持随机访问,但归并排序在合并链表时不需要额外的数组空间,空间复杂度可降至 。
- 适合外排序(External Sorting): 当数据量过大(如几百GB),无法一次性全部载入内存时,归并排序可以将大文件切分为小块分批排序后,通过多路归并(Multi-way Merge)高效完成全量数据的排序。
- 空间开销稍大: 需要 的额外内存空间(对于数组排序),属于非原地排序算法(In-place Sort)。
- 小数据量下开销大: 频繁的递归调用和数组拷贝会导致在数据量极小时(如 ),效率不如插入排序或简单选择排序(工程中常在归并到小数据块时切回插入排序进行优化)。