并查集
并查集是一种用于处理元素分组的集合数据结构,支持两个核心操作:合并两个集合、查询两个元素是否属于同一集合,借助路径压缩与按秩合并优化,能近乎常数时间完成操作,常用于连通性判断、图论连通分量等场景。
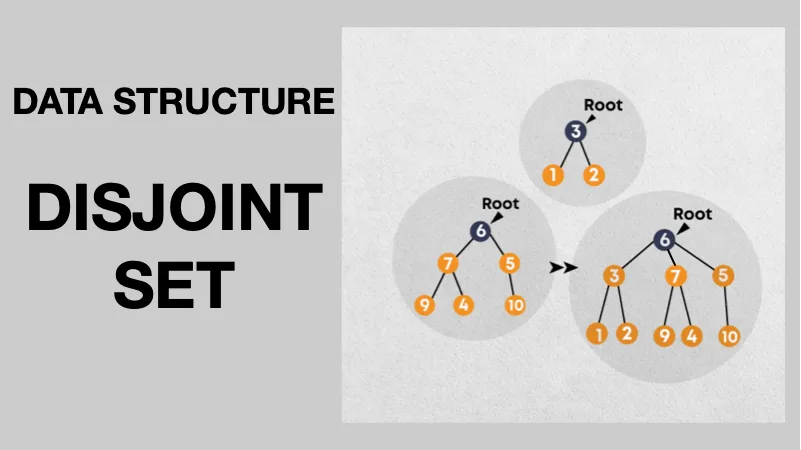
并查集(Disjoint-set / Union-find data structure) 是一种非常高效且精妙的树型数据结构,主要用于处理不相交集合的合并与查询问题。
简单来说,它可以帮我们快速回答两个问题:
- 查询(Find): 两个元素是否属于同一个集合(或者说,它们是否连通)?
- 合并(Union): 把两个不同的集合合并成一个集合。
在现实生活中,并查集最直观的比喻就是 “找帮派大佬” 或 “查亲戚关系”:每个人都只记住自己的直接上级(父节点),顺着上级一直往上找,找到的最顶层大佬(根节点)就是这个帮派的代表。如果两个人的最顶层大佬是同一个人,说明他们属于同一个帮派。
并查集底层通常只需要一个一维数组 parent[] 来实现。数组的下标代表元素,数组存的值代表该元素的父节点。
最开始时,每个元素自成一派,各自是自己的根节点(自己是自己的老大)。
- 数据表示:
parent[i] = i - 示意图: 如果有 4 个元素,
[0], [1], [2], [3],它们互相独立。
要判断某个元素属于哪个集合,就需要顺着父节点递归向上寻找,直到找到一个满足 parent[x] == x 的节点,这个节点就是代表节点(根节点)。
如果单纯地向上找,极端情况下树可能退化成一条链(比如 ),导致查询效率降为 。
为了解决这个问题,我们在查询的过程中顺便做一次“扁平化”处理:在找根节点的同时,把路径上经过的所有节点,直接挂到根节点下面。下次再找的时候,一步就能到位!
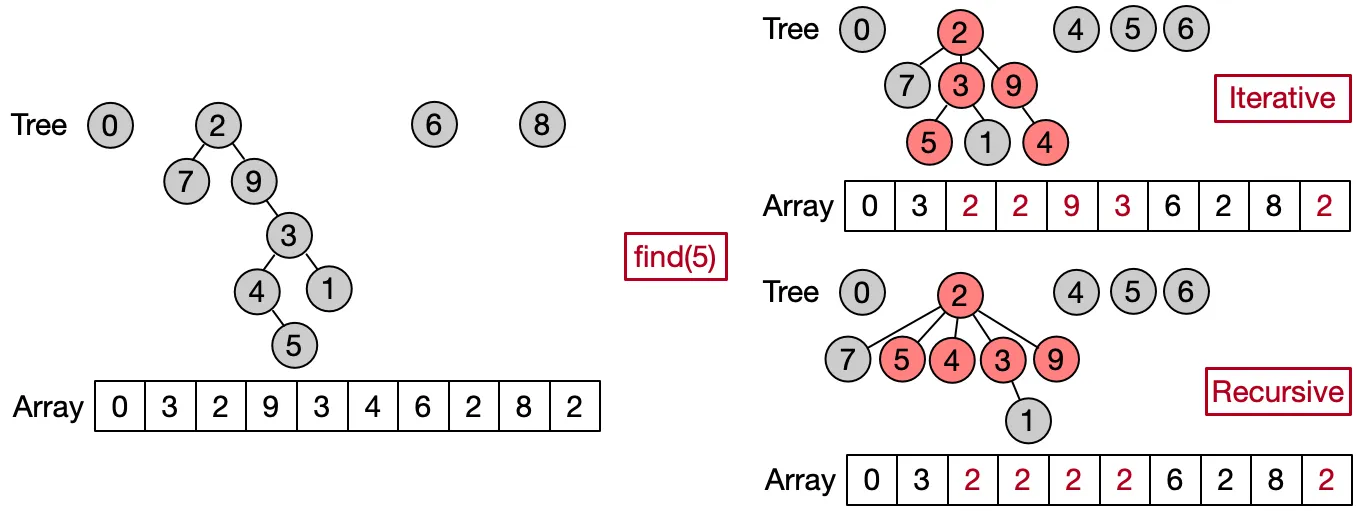
int find(int x) { if (parent[x] != x) { parent[x] = find(parent[x]); // 路径压缩:直接指向根节点 } return parent[x];}合并元素 x 和 y 所在的集合时:
- 先分别找到它们所在集合的根节点:
rootX = find(x),rootY = find(y)。 - 如果
rootX != rootY,说明它们还不在同一个集合中,将其中一个根节点的父节点设为另一个即可:parent[rootX] = rootY。
如果总是随机合并,树的深度可能会越来越高。按秩合并的思想是:让“小树”挂到“大树”下面(通常用树的高度或节点数量作为“秩”),从而控制树的高度增长。
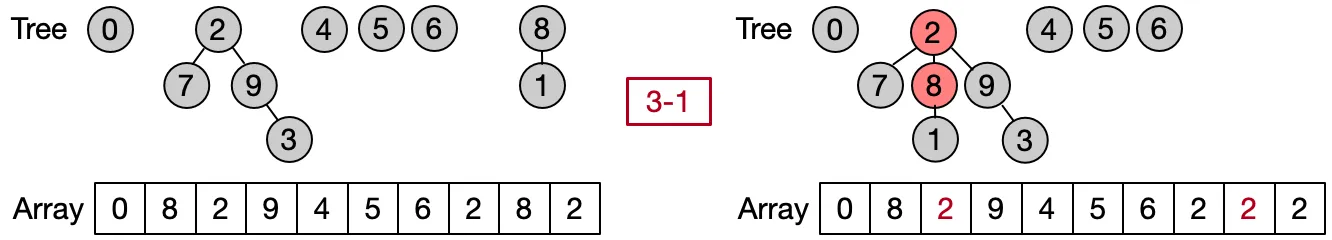
要想区分大树和小树(即按秩合并),必须额外引入一个数组 sz[] 或 rank[] 来记录节点数量或树的高度。
按节点数量合并
通过维护 sz[] 数组记录每棵树的元素个数,永远让节点少的小树挂到节点多的大树下面。
// 初始化时:parent[i] = i, sz[i] = 1
void unite(int x, int y) {    int rootX = find(x);    int rootY = find(y);
    if (rootX != rootY) {        // 判断哪个树小,将小树挂到大树上        if (sz[rootX] < sz[rootY]) {            parent[rootX] = rootY;  // rootX 较小,挂到 rootY 下            sz[rootY] += sz[rootX]; // 更新大树的总节点数        } else {            parent[rootY] = rootX;  // rootY 较小,挂到 rootX 下            sz[rootX] += sz[rootY]; // 更新大树的总节点数        }    }}
按树的高度合并
通过维护 rank[] 数组记录树的高度,永远让矮树挂到高树下面。
// 初始化时:parent[i] = i, rank[i] = 0
void unite(int x, int y) {    int rootX = find(x);    int rootY = find(y);
if (rootX != rootY) { // 判断树的高矮 if (rank[rootX] < rank[rootY]) { parent[rootX] = rootY; // 矮树挂高树,高度不增加 } else if (rank[rootX] > rank[rootY]) { parent[rootY] = rootX; // 矮树挂高树,高度不增加 } else { parent[rootX] = rootY; // 一样高时随便挂,树高增加 1 rank[rootY]++; } }}以下是一个封装好的标准并查集模板:
#include <vector>#include <numeric>
class UnionFind {private:    std::vector<int> parent; // 存储每个节点的父节点    std::vector<int> sz;     // 存储以该节点为根的树的大小(节点数量)    int count;               // 存储当前独立的集合总数
public:    // 构造函数:初始化 n 个独立元素    explicit UnionFind(int n) : parent(n), sz(n, 1), count(n) {        // 使用 iota 快速完成 parent[i] = i 的初始化        std::iota(parent.begin(), parent.end(), 0);    }
    // 查找代表节点(带路径压缩)    int find(int x) {        if (parent[x] != x) {            parent[x] = find(parent[x]); // 路径压缩:递归挂到根节点下        }        return parent[x];    }
    // 按大小合并(Union by Size):让小树挂到大树下面    bool unite(int x, int y) {        int rootX = find(x);        int rootY = find(y);
        // 如果已经在同一个集合中,无需合并        if (rootX == rootY) {            return false;        }
        // 比较 size:小树合并到大树        if (sz[rootX] < sz[rootY]) {            parent[rootX] = rootY;            sz[rootY] += sz[rootX];        } else {            parent[rootY] = rootX;            sz[rootX] += sz[rootY];        }
        count--; // 合并成功,独立集合数减 1        return true;    }
    // 判断 x 和 y 是否属于同一个集合    bool connected(int x, int y) {        return find(x) == find(y);    }
    // 获取元素 x 所在集合的大小    int getSetSize(int x) {        return sz[find(x)];    }
// 获取当前图中的独立集合总数 int getCount() const { return count; }};- 未优化: 最坏时间复杂度为 。
- 优化后(路径压缩 + 按秩合并): 单次操作的均摊时间复杂度为 。
- 图的连通性问题: 动态判断无向图中两点是否连通,或者计算无向图中的连通分量个数(如:岛屿数量类问题)。
- 最小生成树算法(Kruskal 算法): 用于判断加入一条边后是否会形成环。
- 朋友圈/社交网络问题: 动态合并好友圈子,查询两个人是否有共同的朋友圈。