图的实现
图的实现是通过邻接矩阵或邻接表等方式存储顶点与边的信息,以此来表示图中各个节点之间的连接关系,支撑图的遍历、查找等各类算法操作。
数据结构1分钟阅读
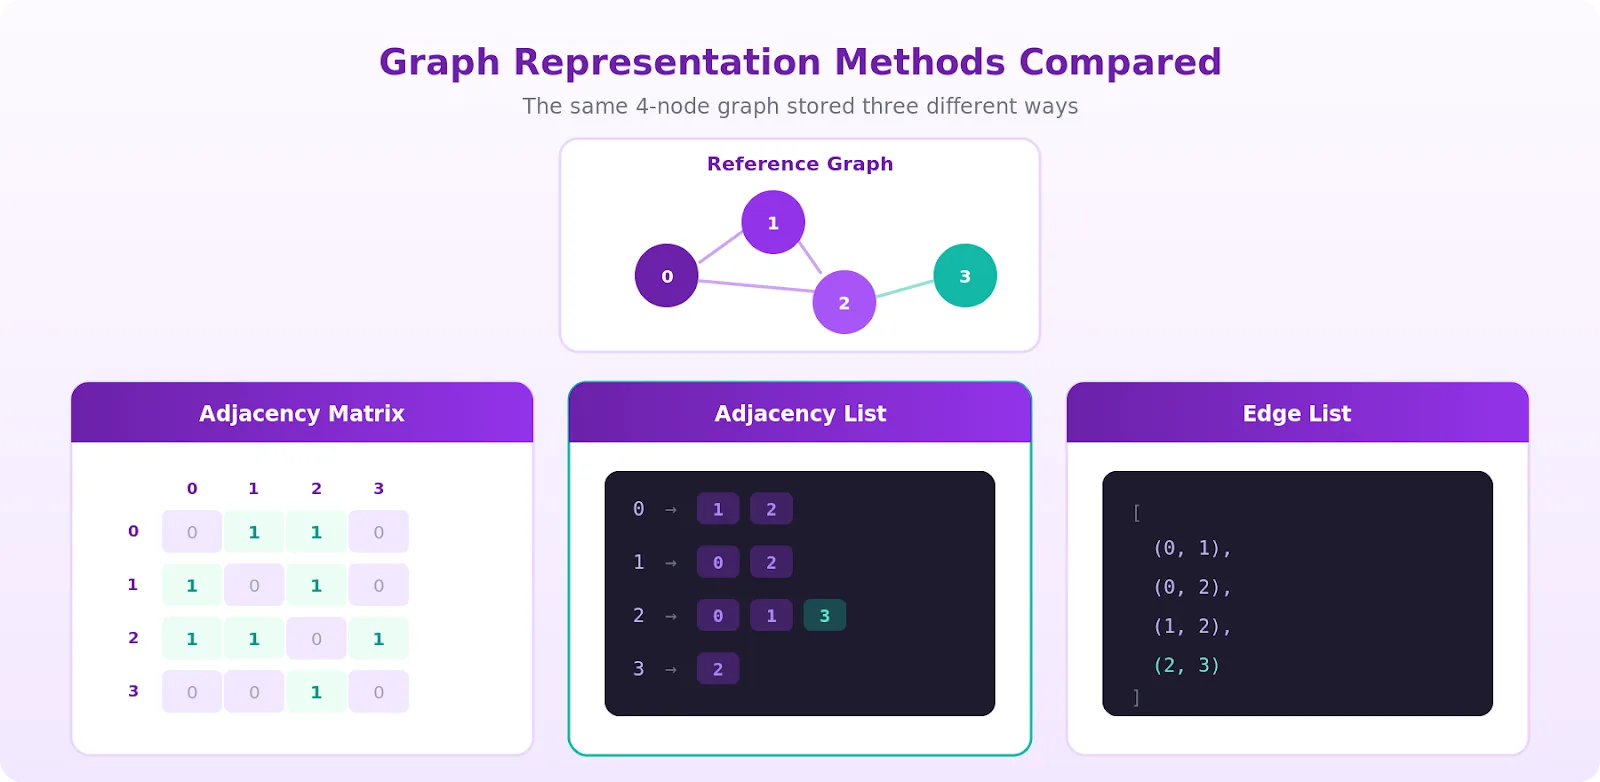
在计算机中,图的存储主要解决两个基本问题:“如何保存点与边的关系” 以及 “如何在空间消耗与查询效率之间做出权衡”。
现实中最常见的两种存储方式是 邻接矩阵(Adjacency Matrix) 和 邻接表(Adjacency List)。
邻接矩阵使用一个 的二维网格(Grid)来存储图。如果从节点 到节点 存在一条边,则矩阵中的单元格位置 [u][v] 记为 1(或者边的权值 Weight);如果不存在边,则记为 0(或无穷大 )。
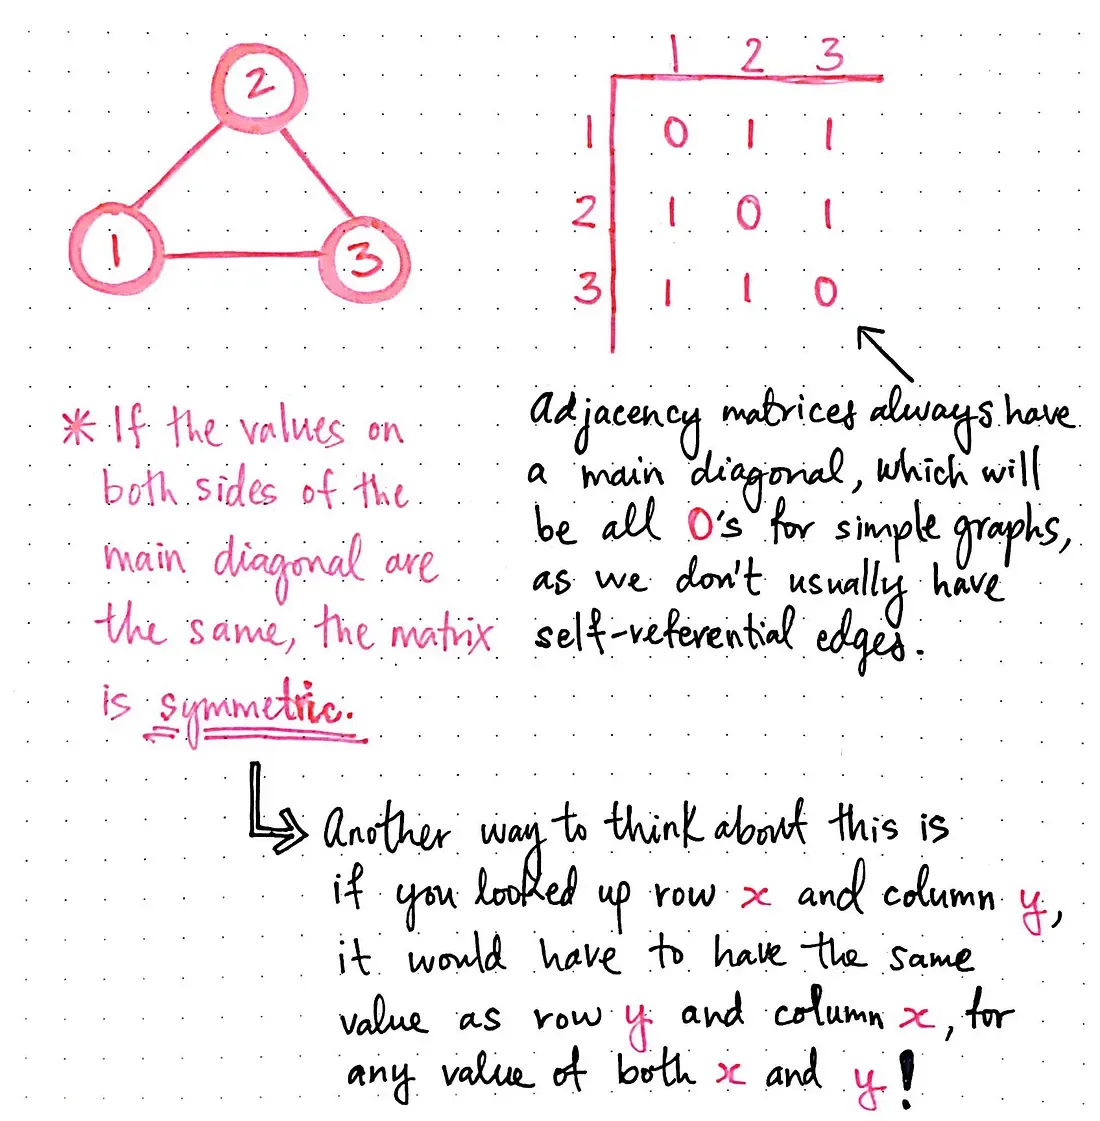
- 查询效率 :检查任意两个顶点 之间是否存在边极其高效,只需常数时间 。
- 遍历邻接点 :遍历某个节点的所有邻居节点需要 的时间,因为必须扫描该节点对应的整行数据。
- 空间复杂度 :消耗的空间直接与顶点数量的平方成正比。
对于稀疏图(Sparse Graph),占用空间随顶点数量平方级增长的开销是灾难性的。例如,一个拥有 100 万个节点的真实社交网络,如果用邻接矩阵存储,将需要 1 万亿个单元格(Trillion Cells),而其中绝大多数位置都只是无意义的 0。
const int MAX_V = 1000;const int INF = 0x3f3f3f3f;
int g_matrix[MAX_V][MAX_V]; // 二维网格
// 建图void add_edge_matrix(int u, int v, int w = 1, bool directed = false) {    g_matrix[u][v] = w;    if (!directed) g_matrix[v][u] = w;}
// 遍历邻居:必须扫完整行 O(V)void traverse_matrix(int u, int num_v) { for (int v = 0; v < num_v; ++v) { if (g_matrix[u][v] != INF && u != v) { // 访问邻居节点 v,权值为 g_matrix[u][v] } }}邻接表使用一个数组(或哈希表),其中每个节点都指向一个存储其所有邻居顶点的列表(List / Dynamic Array)。
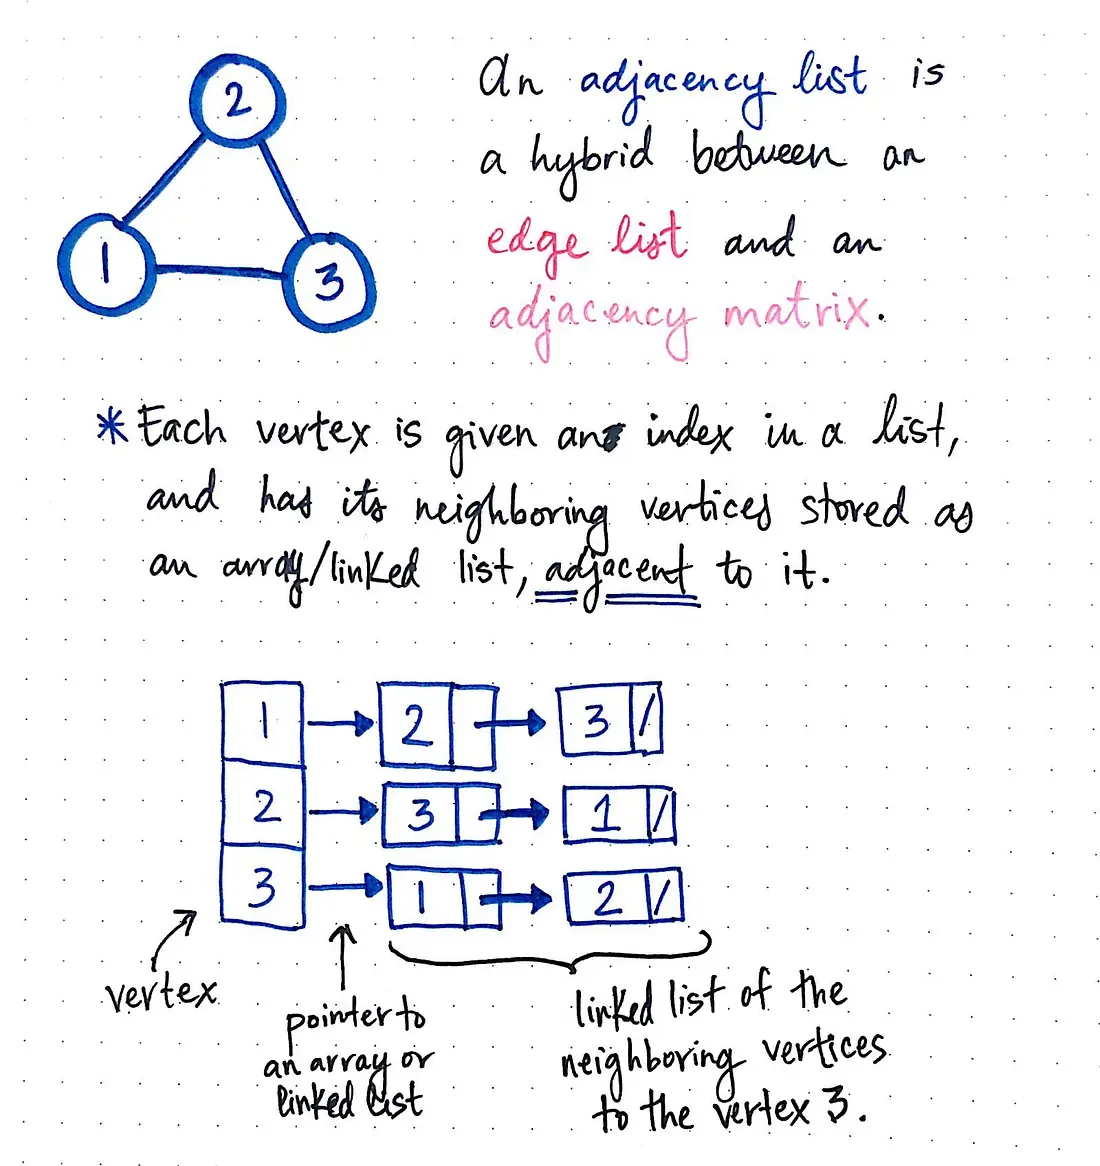
- 空间复杂度 :对于现实世界中的绝大多数图来说,邻接表是最理想的存储方案,因为真实场景下的图绝大多数都是稀疏的(边的数量远小于 )。
- 遍历邻接点 :遍历某个节点的所有邻居非常高效,时间仅取决于该节点的度数(Degree),不需要做任何无用扫描。
- 查询效率 :取舍(Trade-off)在于,检查一对特定的节点 是否相连不再是常数时间,而是需要遍历对应节点的列表,耗时为 。
#include <vector>
struct Edge {    int to, weight;};
const int MAX_V = 10000;std::vector<Edge> g_adj[MAX_V]; // 每个节点指向其邻居列表
// 建图void add_edge_list(int u, int v, int w = 1, bool directed = false) {    g_adj[u].push_back({v, w});    if (!directed) g_adj[v].push_back({u, w});}
// 遍历邻居:仅需 O(degree(u))void traverse_list(int u) {    for (const auto& e : g_adj[u]) {        // 访问邻居节点 e.to,权值为 e.weight    }}